构建 Coding Agent 的飞轮:Feedback Loop、Benchmark、Agent Engineers
来源:InfoQ AI · 发布于 2026/6/12
在 AI 编程助手赛道持续升温的当下,模型层的能力跃迁几乎以周为单位迭代——从 Claude Opus 到 GLM、Kimi、MiniMax 再到 GPT 系列,新模型密集发布已成为常态。然而对于构建上层 Agent 应用的团队而言,模型能力的剧烈变化恰恰构成了最大的架构挑战。
本文整理自百度文心快码研发经理牛万鹏在 QCon 全球软件开发大会 2026 北京站的分享《构建 Coding Agent 的飞轮:Feedback Loop、Benchmark、Agent Engineers》。他在演讲中系统性地拆解了这一困境,并给出了 Comate 团队在 Feedback Loop、Benchmark 构建以及 Agent Engineers 三个维度的实践方法论。文章将覆盖 Comate 在百度内部落地的数据成果、双层 Loop 的 Agent 架构设计、线上数据驱动的反馈闭环机制、基于异常值而非分数的评测体系建设,以及在工具执行网络、复杂度路由等方面的具体工程实践。
6 月 26~27 日的 AICon 上海站将锚定行业前沿,聚焦 Al Infra 系统工程、多 Agent 协作与实践、多模态融合、模型训练与推理创新、数据平台与特征服务,邀您共同深入探讨:(待补充)详细日程见:https://aicon.infoq.cn/2026/shanghai/schedule
以下是演讲实录(经 InfoQ 进行不改变原意的编辑整理)。
Coding Agent 在百度落地的效果
近期北京天气变化剧烈,前两日阴雨绵绵,今日气温却已飙升至二十余度,因未能及时增减衣物而不慎感冒。这件事让我联想到一个颇为贴切的行业现象。这一周 Claude 发布了新模型 Opus,再往前数周,智谱的 GLM、Kimi、MiniMax 以及 GPT 等各类模型接续发布,密集程度堪比天气变化。Comate 是做上层应用的团队,并不训练模型。然而如果应用层不能有效适配模型的快速变化,同样会“感冒”——Comate 曾经就经历过这样的困境。
因此,当我们不去训练模型,而是选择构建 Agent 的时候,如何有效适配这些模型的变化,如何让 Agent 框架和 Agent 产品在面对模型能力跃迁时保持弹性,面向未来做架构设计,就构成了本次分享的核心命题。我们将从 Feedback Loop、Benchmark 以及 Agent Engineers 三个方向展开。这不是一套空洞的方法论,而是来自一线实践的压箱底干货。
先看这套方法论在百度内部落地的实际成效。以横轴表示百度全员中适合使用 Agent 的非开发者和开发者的每周使用 Query 次数作为衡量指标——所谓一次 Agent Query,即用户写一个 Prompt 让 Agent 帮忙完成一件事。数据显示,Query 数量的增长曲线在某一个时间点出现了极为陡峭的爬升。截至三月底的数据表明,百度员工在使用 Agent 时,每周人均 Query 次数已达到九十余次,意味着一周之内发出了将近一百次任务请求,每一个 Query 都代表了一个被委托给 Agent 的任务。我们之所以选择人均 Query 数而非 Token 消耗量作为衡量指标,原因在于 Query 本身能更精确地映射出 Agent 实际完成的任务数量,而 Token 数量则很难直接反映完成了多少任务以及提效的具体幅度。
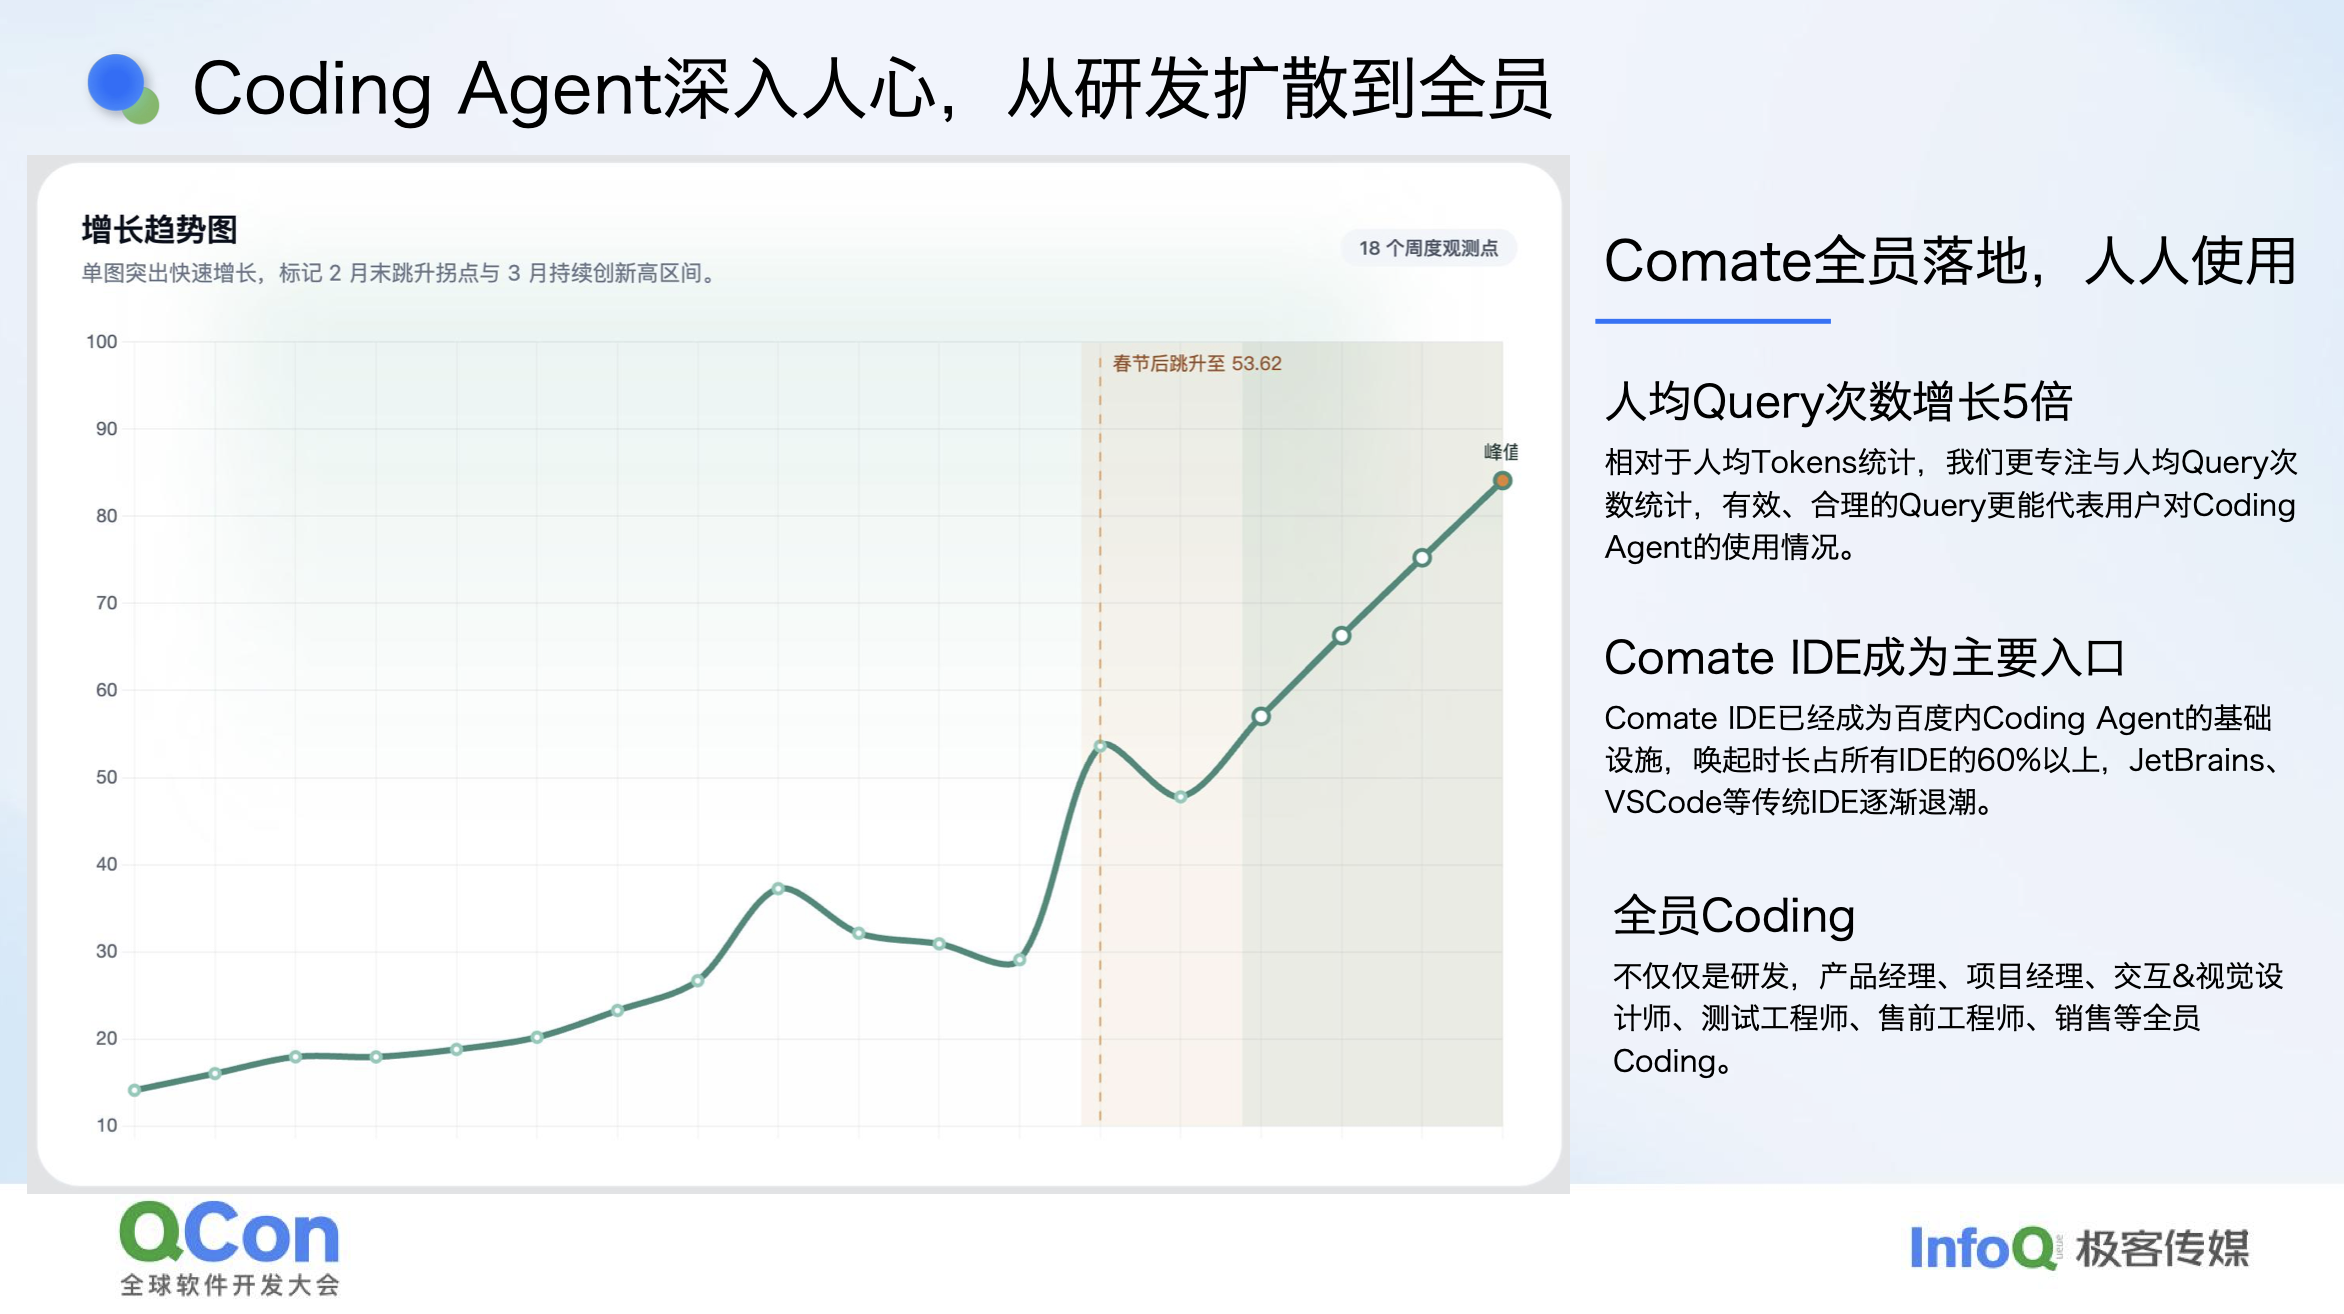
与此同步发生的还有另一个变化。Comate 拥有自己的 IDE,类似于 Cursor 的体验,也提供 JetBrains 插件和 VS Code 插件。我们越来越发现,更多用户选择直接使用 Comate IDE,放弃 JetBrains 和 VS Code。他们不单单在里面写代码,编译和调试等工作也一并迁移了过来。与此同时,使用者的角色边界也在被打破。产品经理尚属研发圈子,但令人始料未及的是,售前工程师和销售人员竟然也开始使用 Agent,用来分析数据、做项目管理,这一现象完全超出了我们最初的预期。
这些用户在用 Agent 做什么?本质上都可以归入 Vibe Coding 的范畴,但具体可以划分为两个截然不同的类型。
第一类场景是非开发者解决那些“大量可以用研发能力解决,但永远不会被纳入研发排期”的工作。一个典型的例子是产品经理的数据统计诉求。过去,产品经理需要找到研发同事,请求帮忙写一条 SQL 到数据库里查询过去一周的日活和留存数据,研发还需要担心查询数量过大可能导致锁表。而现在,我们直接让产品经理拿着 Agent 连接数据库,配一个只读账号即可自行完成查询。这类需求优先级不高,但始终存在,产品经理通过 Agent 立刻就能满足。
这里可以引入一个颇具启发性的类比。当前俄乌战场上无人机的使用方式呈现出一种非常有意思的特点。假设战场上发现十公里外有两名敌人,车辆无法靠近,枪械也打不到。此时如果要调动炮兵,需要请示师长级别才能做出决策,整条决策链路相当漫长,等到审批完成敌人早已离开。更严重的是,即使决策链路完成了,一发炮弹打出去,炮兵阵地也随之暴露,对手很有可能就是拿这两名士兵做诱饵,旨在吸引你的炮兵暴露位置。放在研发层面上,这完全是一个逻辑自洽的隐喻。当我们真正要去实现一个 Feature 的时候,需要调动大量研发精力和团队协作,耗费海量资源。等我们做出来,很可能这个产品或者这个 Feature 已经不复存在,已经错过了窗口期。Agent 的出现在很大程度上解决了这类问题——它没有将决策链条拉得过长,也不需要耗费整建制的研发资源。
第二类场景是真正的严肃开发,即我们日常的软件迭代。放在三个月前,即便在团队内部讨论时,我也认为 Vibe Coding 在这类场景上不靠谱,只能覆盖第一种类型的需求,第二种做不了。但现在情况已经完全不同了。包括 Comate 研发团队自身,也在大量使用 Agent 来生成 Agent。一个根本性的变化在于,开发者个人从执行者变成了问题的提出者。我们越来越发现,制约效率的瓶颈已不再是 Token 价格是否昂贵,而在于一个人能不能提出一个好问题,去让 Agent 帮我们实现它。在面向研发团队的变化中,另一个趋势同样显著。我们正在推进全栈,但这种全栈并非传统意义上的“Java 工程师因为有了 Agent 就可以写 Python 了”,不是编程语言层面的全栈。我们所理解的全栈,是角色维度的全栈——集产品经理的 Sense、交互视觉的 Sense 以及构建测试边界的 Sense 于一身。正是这样的全栈能力,才能充分激发 Agent 的能力。
在这种全栈的驱动下,越来越多的大型 Feature 被拆解为小型 Tasks。过去需要多人并行执行的任务,现在反而倾向于直接交由一个人搭配 Agent 把整个事项全部完成——效率更高,质量也更优。
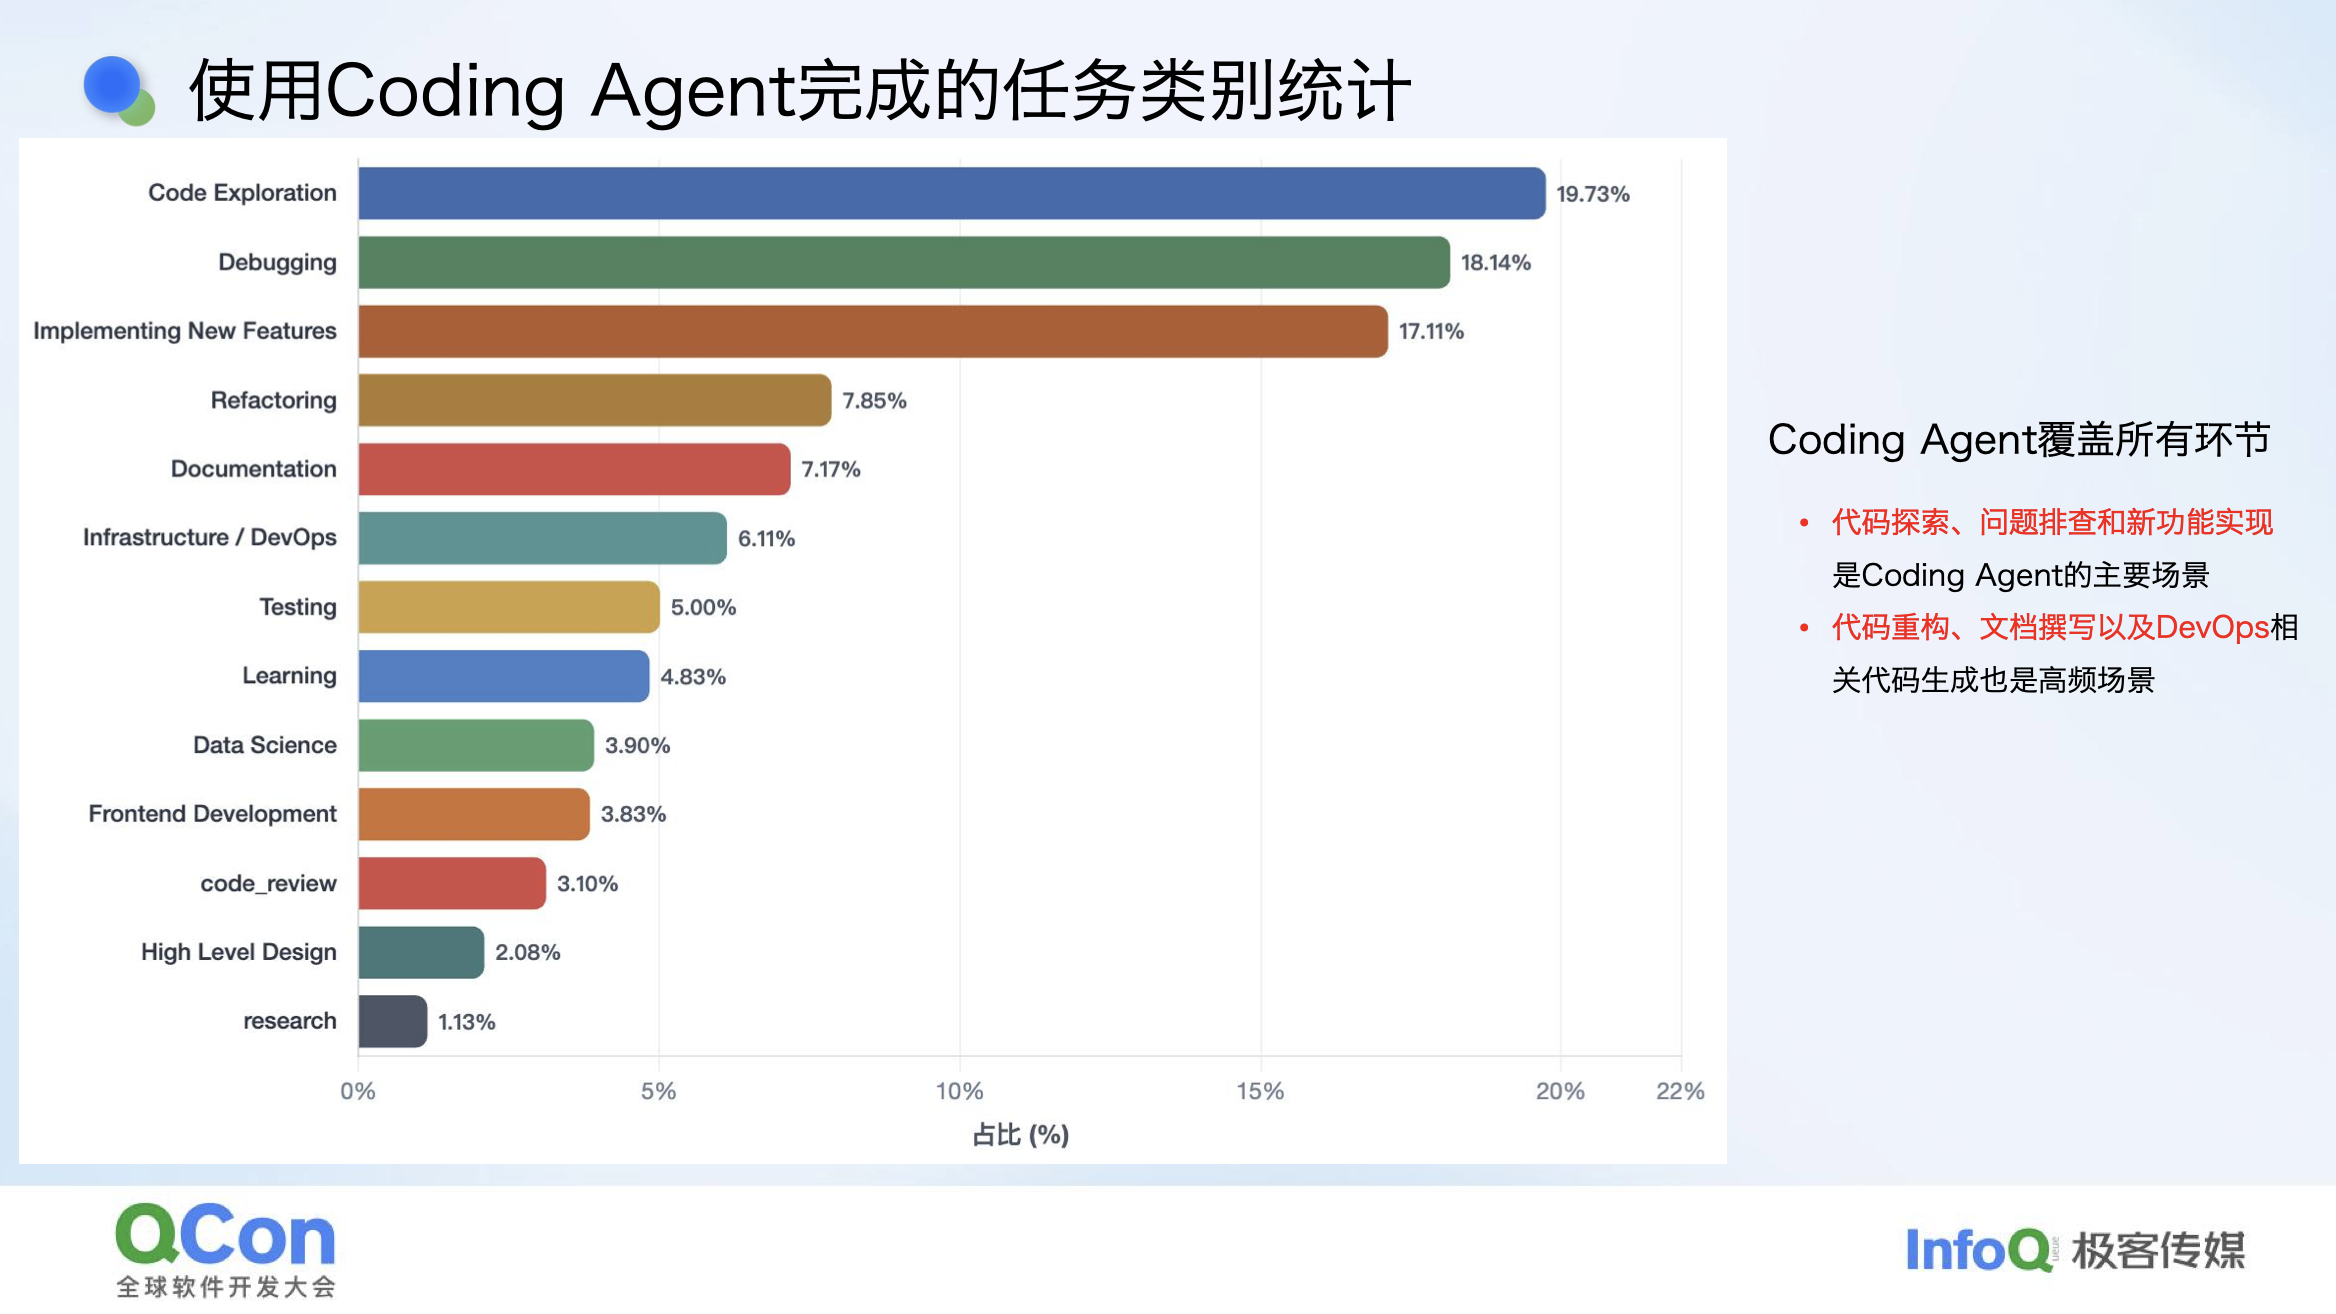
进一步细化这些 Query 的类别,我们可以从百度一周的数据来看。整体可以归入几个大类,其中有三类体量最大。第一类是 Code Exploration,即代码探索,包括代码检索和代码解释——让 Agent 帮忙解释问题、探索代码库、做技术调研等。这一类占比几乎最高,接近百分之二十。大量的人在使用 Agent 获取信息。第二类是 Debug,即排查错误,每天把日志提供给 Agent,请它帮助定位问题。第三类才是实现新 Feature。这一分布完全符合工程师的直觉:每天我们真正在做的事情并不是实现新功能,而是研究和排查问题。
Agent Loop 的基本框架和问题
基于这些线上数据,Comate 正在搭建的 Agent 框架采用了两层 Loop 的设计。这一结构我们当初构思出来时觉得格外精妙。中间层 Loop 由工具、环境和模型三者构成最基本的 Agent 闭环框架。外围第二层 Loop 则赋予 Agent 更多手脚去探索外部环境,包含记忆(Memory)、技能(Skill)、规则(Rules)、MCP 以及 Agents 本身——即所谓的边界条件。前段时间 Claude Code 源码泄露的时候,相信在座有老师已经注意到,源码里面大量的边界条件处理令人难以想象其复杂度。Comate 并不训练模型,因此在最初构
(摘要已截断,点击下方"查看原文"获取完整内容)
↗ 查看原文 / 完整内容
https://www.infoq.cn/article/l7BXlstUWDOBwI30miJU?utm_source=rss&utm_medium=article
 苏公网安备32059002007950号