不换 Kimi 底座,1/10 成本追平 Opus 4.7?Cursor 用 Composer 2.5 反击 Claude Code
来源:InfoQ AI · 发布于 2026/5/20
Cursor 发布了 Composer 2.5,想解决的是 AI 编程里越来越关键的长任务能力。它没有更换基础模型,仍然沿用 Kimi K2.5,而是把重点放在后训练上:用更多训练投入换取更好的基准测试成绩,同时继续维持低价。
Cursor 被 Claude Code 逼急了
过去几个季度,AI 编程市场的主角越来越像是 Anthropic 的 Claude Code。Cursor 仍然是最重要的 AI 编程工具之一,但它曾经那种“默认领先”的气势,确实被削弱了。现在,Cursor 试图用一款自己的模型,把主动权重新拿回来。
这款模型就是刚发布的 Composer 2.5,也是 Cursor 迄今能力最强的内部模型。按照 Cursor 的说法,它在智能水平、长时间任务可靠性和整体可用性上都有明显提升。放在今天的市场环境里,Composer 2.5 不只是一次产品升级,更像是 Cursor 对自主 Agent 竞争的一次正面回应:当竞争焦点从 IDE 体验转向更强的模型和任务执行能力,Cursor 必须证明自己还能继续定义开发者工具。
压力首先来自 Anthropic 的 Claude Code。这个产品已经成长为 Cursor 面前最强劲的对手,据称年化收入超过 25 亿美元,企业客户超过 30 万家。更麻烦的是,Anthropic 有一个 Cursor 很难复制的结构性优势:Claude Code 可以用 Cursor 难以匹配的价格去抢用户,而 Cursor 如果继续依赖 Anthropic 的模型能力,还要反过来为推理成本买单。换句话说,Cursor 一边要和 Anthropic 的 Claude Code 竞争,一边还要向 Anthropic 付钱。自研模型的意义,也就不只是技术路线选择,而是 Cursor 摆脱被动局面的必要动作。
Cursor 自己的数据并不差。到 2025 年年中,它每天仍能生成 10 亿行被接受的代码,财富 500 强企业中也有 67% 是它的客户。但市场兴奋点已经变了。Warp CEO Zach Lloyd 曾对《财富》说:“我不相信‘Cursor 已死’这种梗,但‘IDE 已死’是真的。”这句话点出了 Cursor 现在的处境:用户还在用 IDE,但资本、开发者和市场真正兴奋的,已经转向能独立完成更多工作的自主编程 Agent。Composer 2.5,就是 Cursor 对这场变化给出的回应。
跑分接近,价格更狠
从纸面成绩看,Composer 2.5 具备竞争力。在 SWE-Bench Multilingual 上,它得分 79.8%,只比 Opus 4.7 的 80.5% 略低,高于 GPT-5.5 的 77.8%。
在 Terminal-Bench 2.0 上,它也几乎追平 Opus 4.7,二者分别为 69.3% 和 69.4%,不过 GPT-5.5 以 82.7% 明显领先。
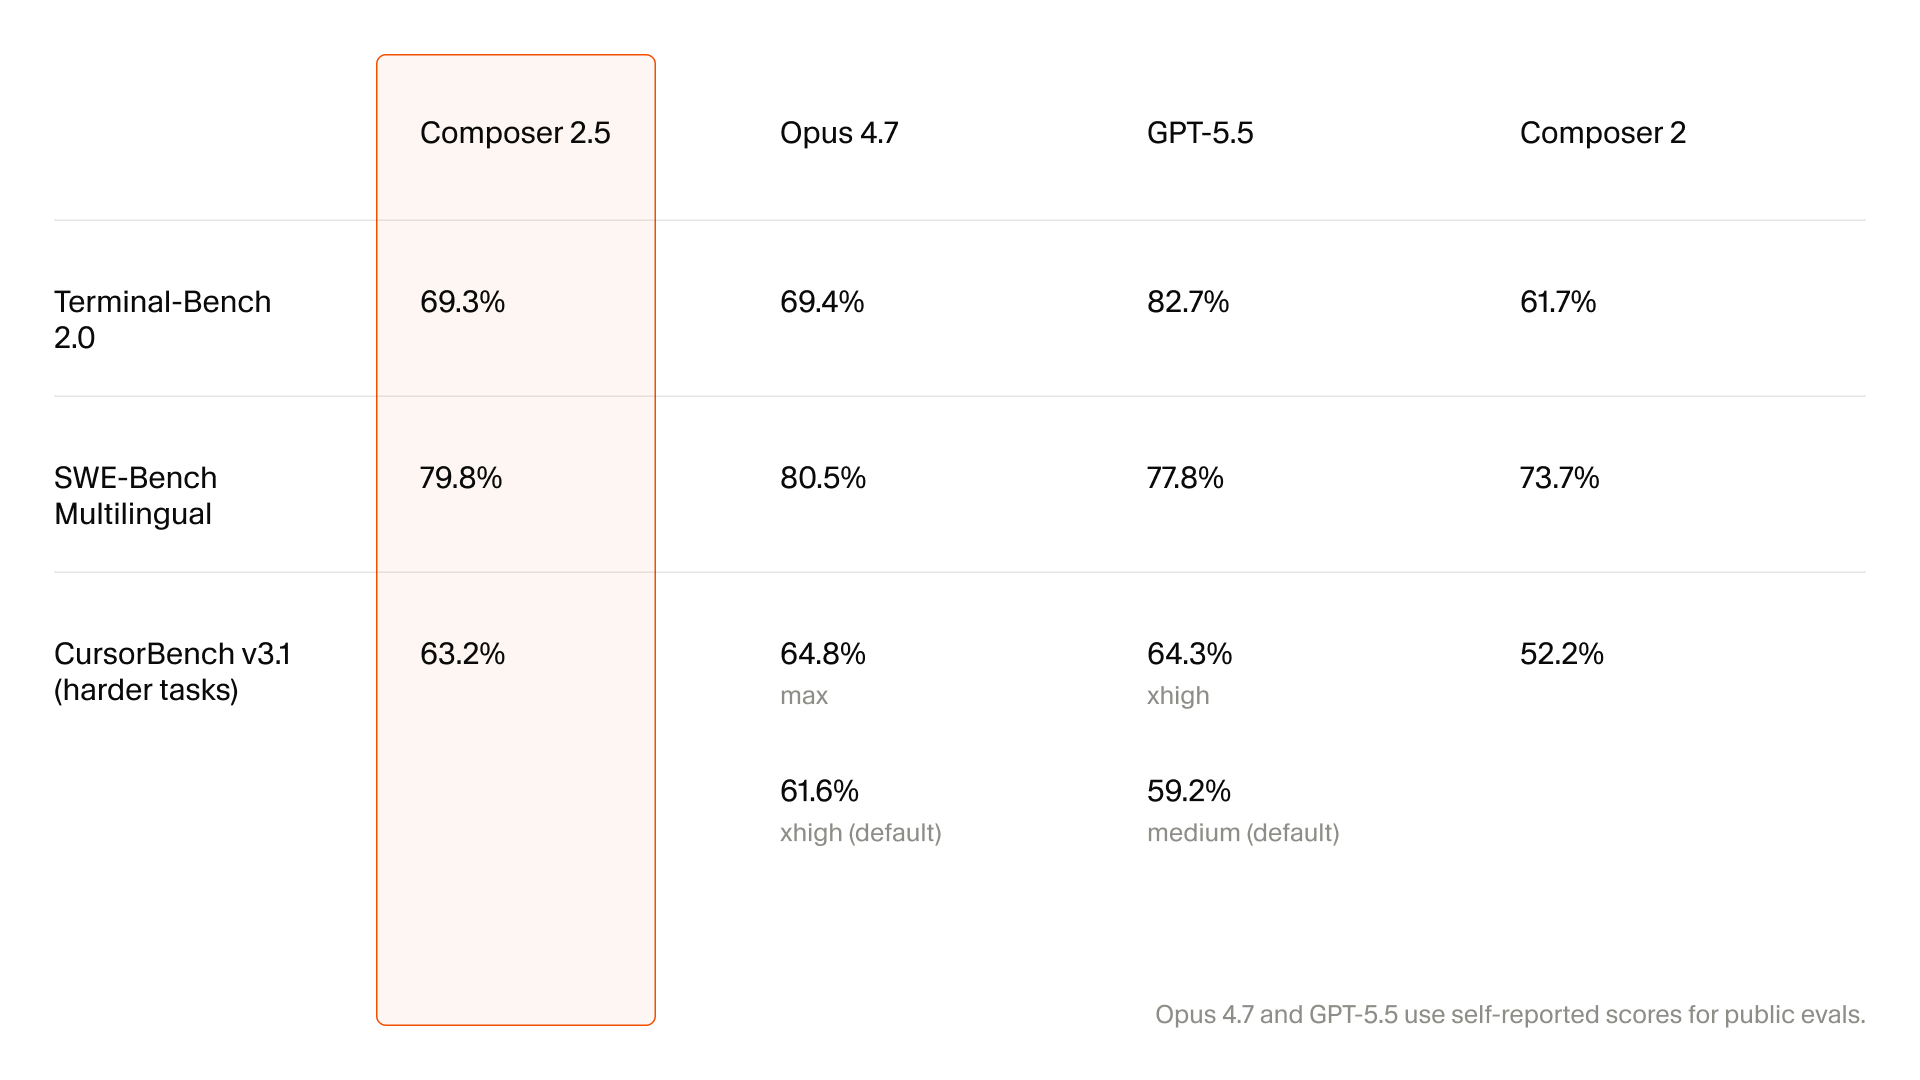
更值得细看的是 CursorBench v3.1,这是 Cursor 自己设计的、更偏困难任务的基准测试。Composer 2.5 在该测试中得分 63.2%。Opus 4.7 在最高设置下得分更高,为 64.8%,但在默认的 xhigh 设置下会降至 61.6%。GPT-5.5 的默认成绩则为 59.2%。
Cursor 最有说服力的地方,其实是成本效率。Composer 2.5 的价格为每百万输入 token 0.50 美元、每百万输出 token 2.50 美元,显著低于可比较的前沿模型。
Cursor 在发布时同步给出的一张 effort curve 图显示,Composer 2.5 在 CursorBench 上能以低于 1 美元的单任务平均成本达到约 63% 的成绩;而在类似或更差结果上,Opus 4.7 和 GPT-5.5 等竞争模型每个任务要贵出数美元。
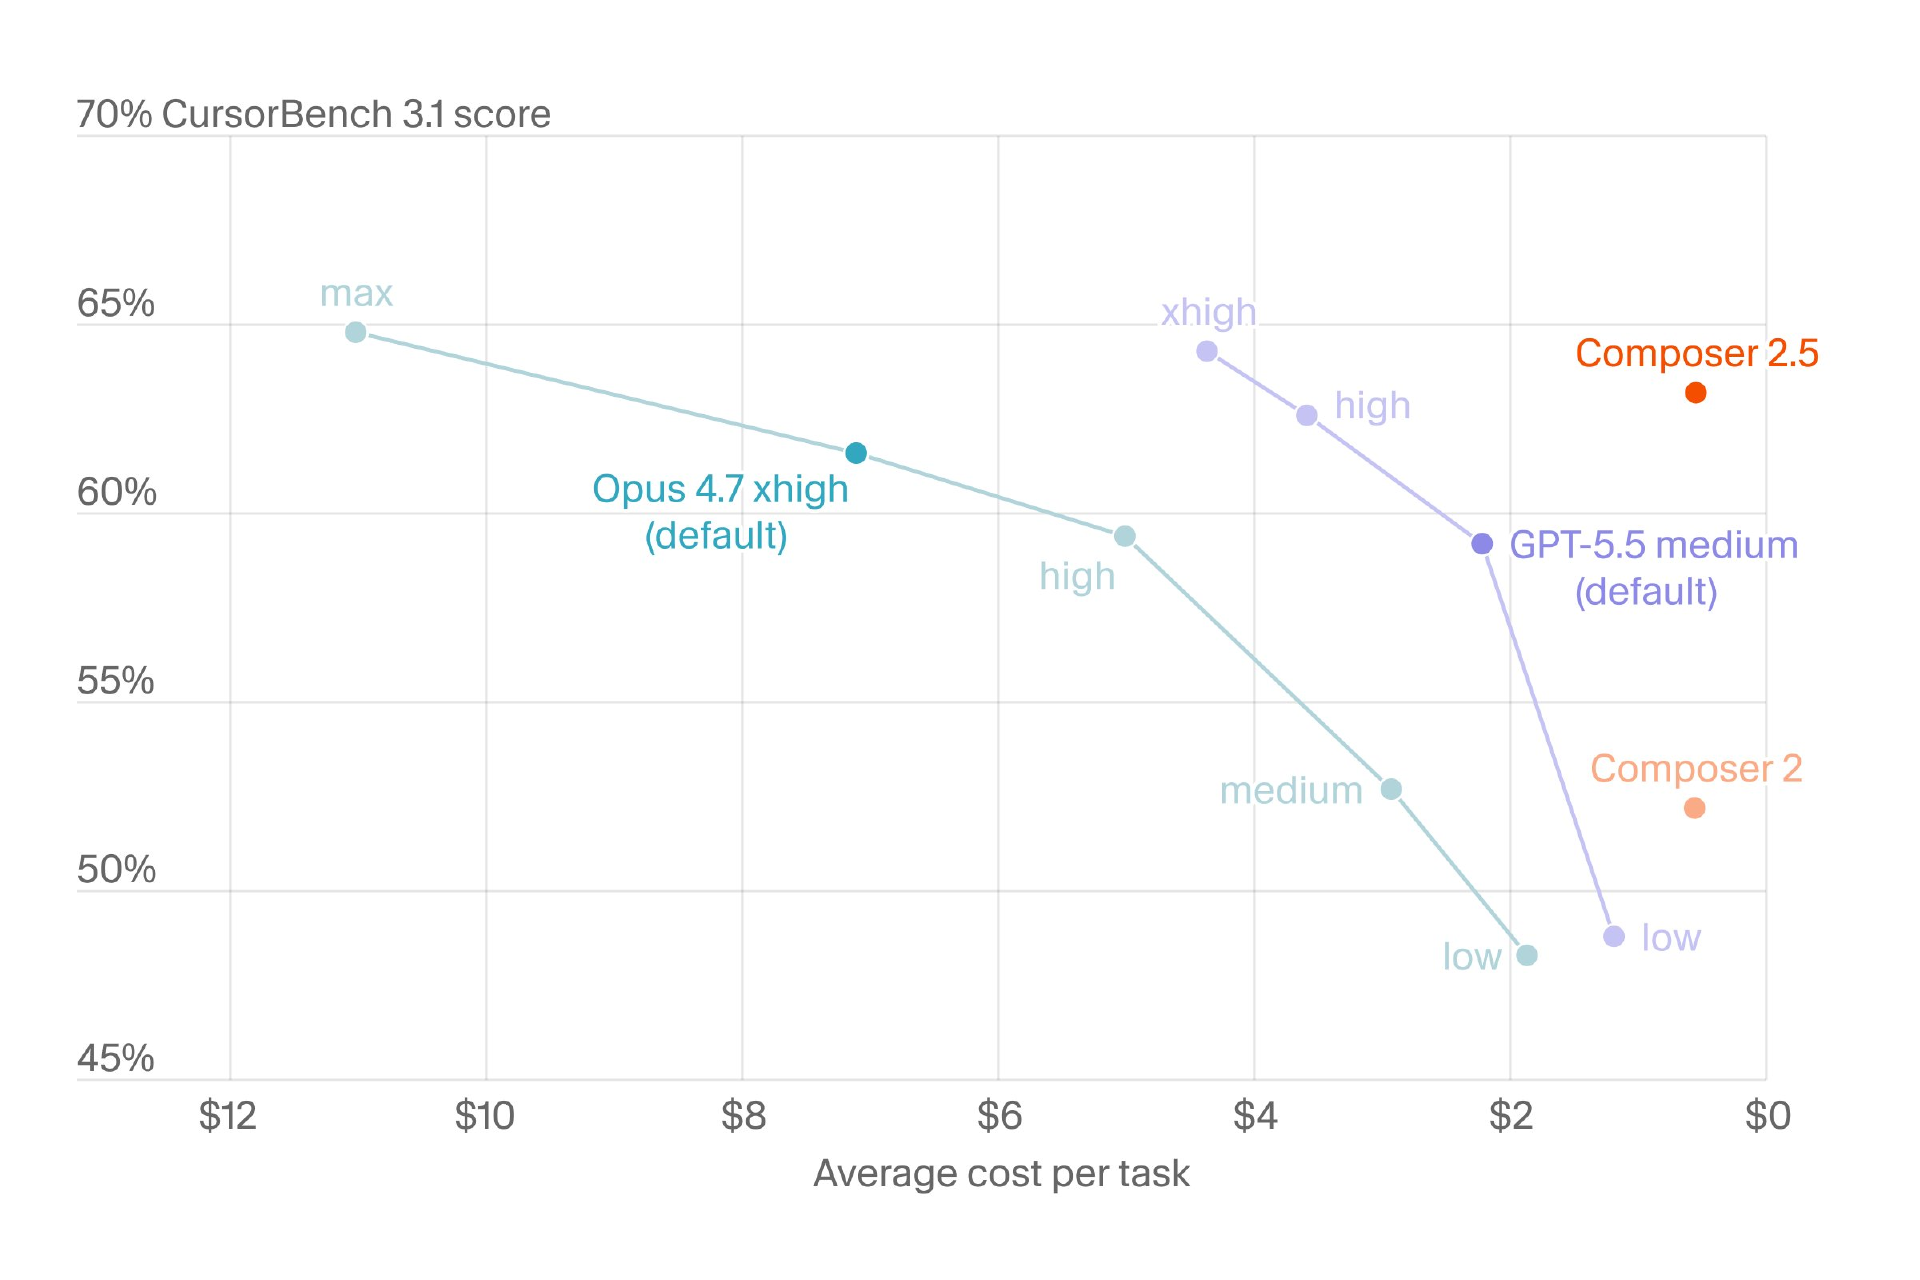
Composer 2.5 在 CursorBench 3.1 上的表现与 Opus 4.7 和 GPT-5.5 相当,但每项任务的成本不到 1 美元——相比之下,竞争对手的成本高达 11 美元。| 图片:Cursor
Kimi 底座没变,Cursor 把赌注押在了后训练上
Cursor 称,Composer 2.5 更适合处理长时间运行的编程任务,在复杂指令下更可靠,也比 Composer 2 更好用。Cursor 同时表示,Composer 2.5 底层仍然沿用此前的 Kimi K2.5,但在此基础上加入了更多调优和训练方法,因此整体表现有所提升。
这也让 Kimi 底座再次成为外界关注的焦点。2026 年 3 月,Cursor 创始人 Aman Sanger 曾回应过 Kimi 披露不足的问题。当时,Cursor 一开始并没有说明 Composer 2 的训练使用了 Moonshot AI 的 Kimi K2.5 模型。Aman Sanger 后来承认:“我们一开始没有在博客里提到 Kimi 底座,这是一个疏漏。下一个模型我们会修正这一点。”
因此,Composer 2.5 也变成了一个很直接的验证题:在不更换基础模型、也不提高入门价格的情况下,单靠更强的后训练,能不能让一个编程 Agent 明显变强。
放到 AI 编程市场里看,Cursor 此前曾在一份 AI 编程助手市场对比中,被认为在原型开发速度上最强。那份对比认 (摘要已截断,点击下方"查看原文"获取完整内容)
↗ 查看原文 / 完整内容
https://www.infoq.cn/article/WHlyjD6dQgPYxmcXWFzO?utm_source=rss&utm_medium=article
 苏公网安备32059002007950号