推荐系统进入“大模型时刻”:昇腾NPU如何支撑千亿级生成式推荐落地
来源:InfoQ AI · 发布于 2026/6/11
导语:
在推荐系统跨入大模型时代的当下,如何利用国产算力底座支撑起千亿级参数模型的高效训推,已成为工业界关注的核心课题。
本文基于华为主任工程师郭威在 2025 AICon 全球人工智能开发与应用大会·北京站 的演讲《基于昇腾 NPU 的生成式推荐 Scaling Law 落地实践》,他深度复盘了华为在推荐技术演进中的前沿探索——从早期对特征工程与模型结构螺旋式上升的探索,到生成式推荐时代的全面转向。文章详尽披露了 FuXi-α、β系列模型的设计思路,揭示了如何通过极致系统优化,解决大规模分布式训练和低时延推理难题。
更具工程参考价值的是,他首次公开分享了华为在“多阶段统一建模”领域的突破性进展,以及针对推荐系统定制的 Performance Law(性能定律)。该定律通过引入“真实熵”度量,精准修正了传统 Scaling Law 在推荐场景下的预测偏差,为极低成本下的参数寻优提供了科学依据。
以下是演讲实录(经 InfoQ 进行不改变原意的编辑整理)
背景介绍
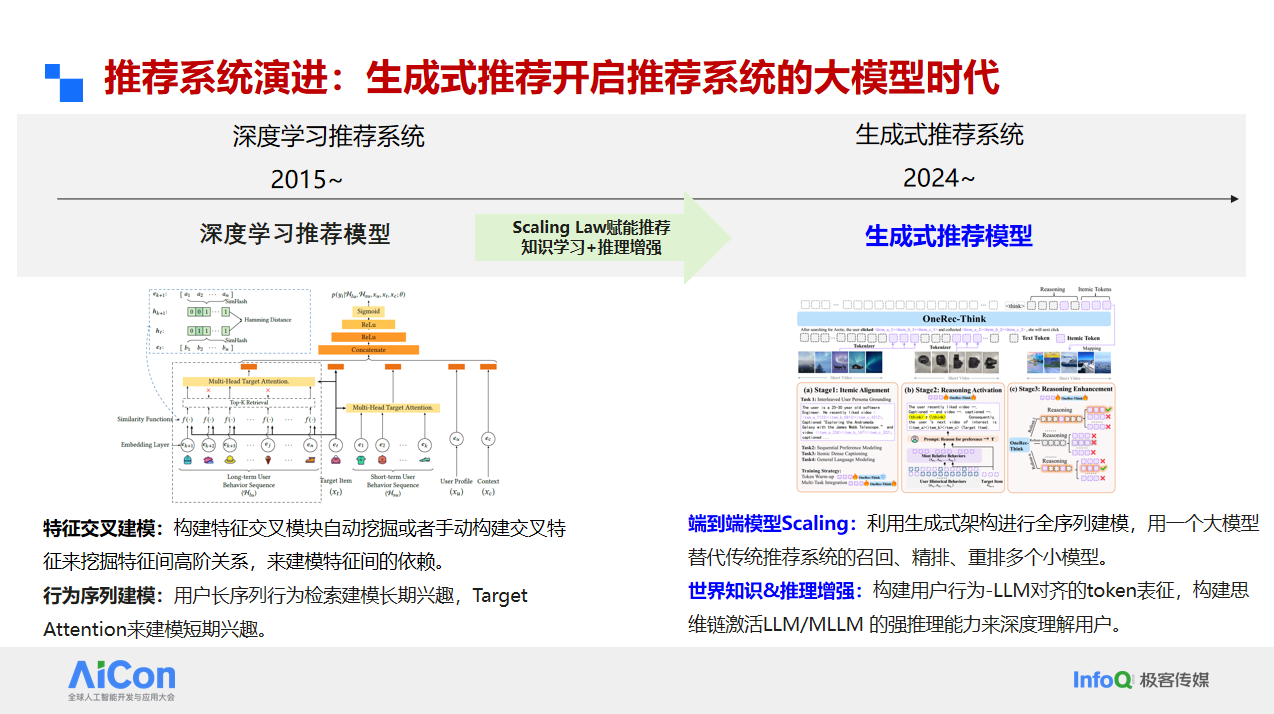
2024 年之前的深度学习推荐技术,主要沿两大路径演进:
一是特征交叉建模,以 DeepFM、DCN 等为代表,核心依托特征交叉模块,自动挖掘或人工构造高阶交叉特征,实现特征间复杂依赖关系的建模;二是行为序列建模,早期研究聚焦短序列场景,借助 DIN 模型的目标注意力机制及 Transformer 结构刻画用户短期兴趣。2021 至 2022 年,长序列建模成为行业研究热点,普遍采用两阶段检索方式,从超长行为序列中萃取关键信息,完成用户兴趣表征。
进入生成式推荐系统阶段后,技术演进依旧分化为两条核心路径。
第一条为端到端模型 Scaling Law,以探索模型规模上限为核心,依托生成式架构对用户全量行为序列进行统一建模,以单一大模型替代传统推荐系统召回、粗排、精排、重排多环节架构,达成推荐全流程端到端建模;第二条自 2025 年下半年起逐步获得业界重视,核心以大语言模型重构底层技术底座,搭建用户行为与大模型的对齐表征空间,借助大模型的逻辑推理能力赋能推荐效果升级。
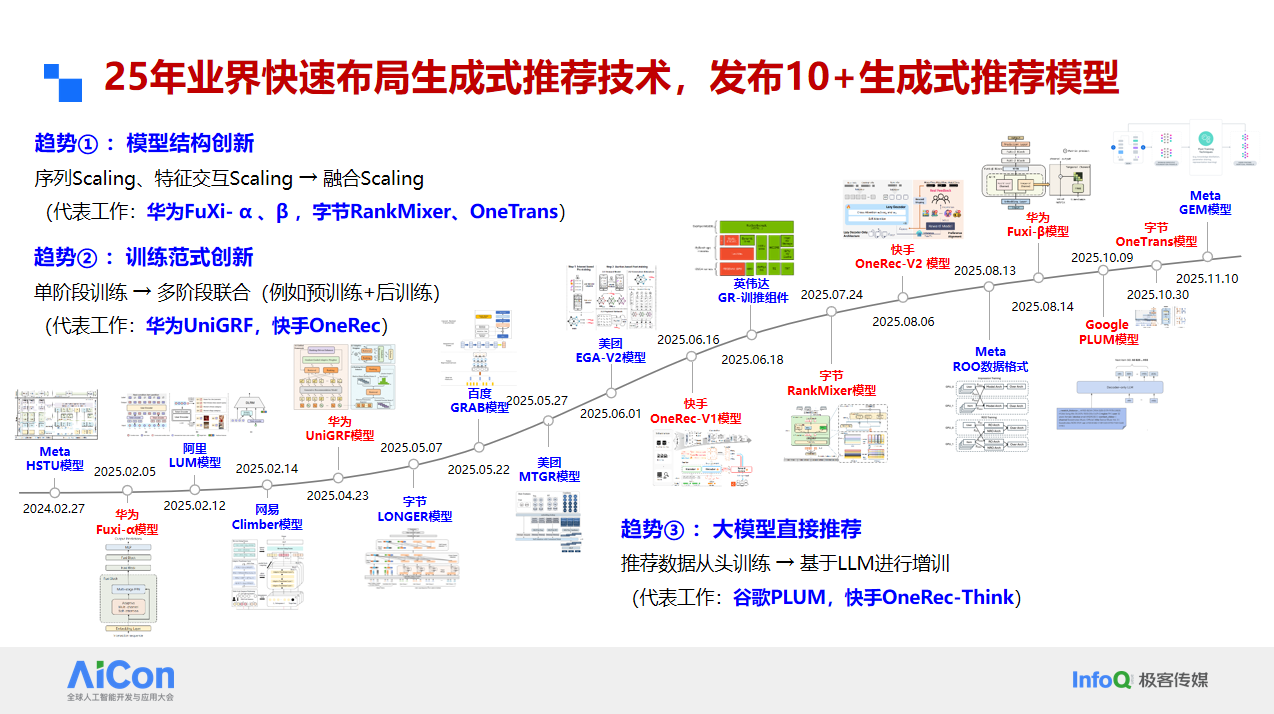
如图所示,展示了 2025 年业界生成式推荐技术的全景概览。可以看到,2025 年是生成式推荐技术快速爆发的一年:不仅有十余家知名机构相继发布标志性成果,相关研究工作也呈现出持续涌现的态势。
整体来看,该领域已经形成较为清晰的技术演进脉络,并可以归纳为三大显著趋势。
首先,模型结构的持续创新。技术演进路径从早期的 HSTU 序列规模化(Scaling),逐步发展到 RankMixer 所代表的特征交互规模化,演进至近期 OneTrans 与 Meta GEM 等模型所采用的融合规模化方案。华为在此领域也贡献了华为 FuXi- α 、β 及 DLF 等工作。
其次,训练范式的革新。随着模型参数规模的扩大及其表征能力的增强,业界开始尝试利用单一模型统一推荐系统中的多个阶段,推动了从单阶段建模向多阶段联合训练的范式转变。这一趋势的典型代表包括华为的 UniGRF、快手的 OneRec-V1 与 OneRec-V2,以及腾讯近期推出的 GPR。
最后,训练方式逐步从“从零训练”转向基于大语言模型的增量式训练。该方向的代表性工作包括谷歌 PLUM 以及快手 OneRec-Think。该范式的核心优势在于引入 LLM 的通用知识与推理能力,从而增强模型对用户行为序列与意图语义的理解能力,并提升整体推荐质量与泛化能力。
模型架构探索
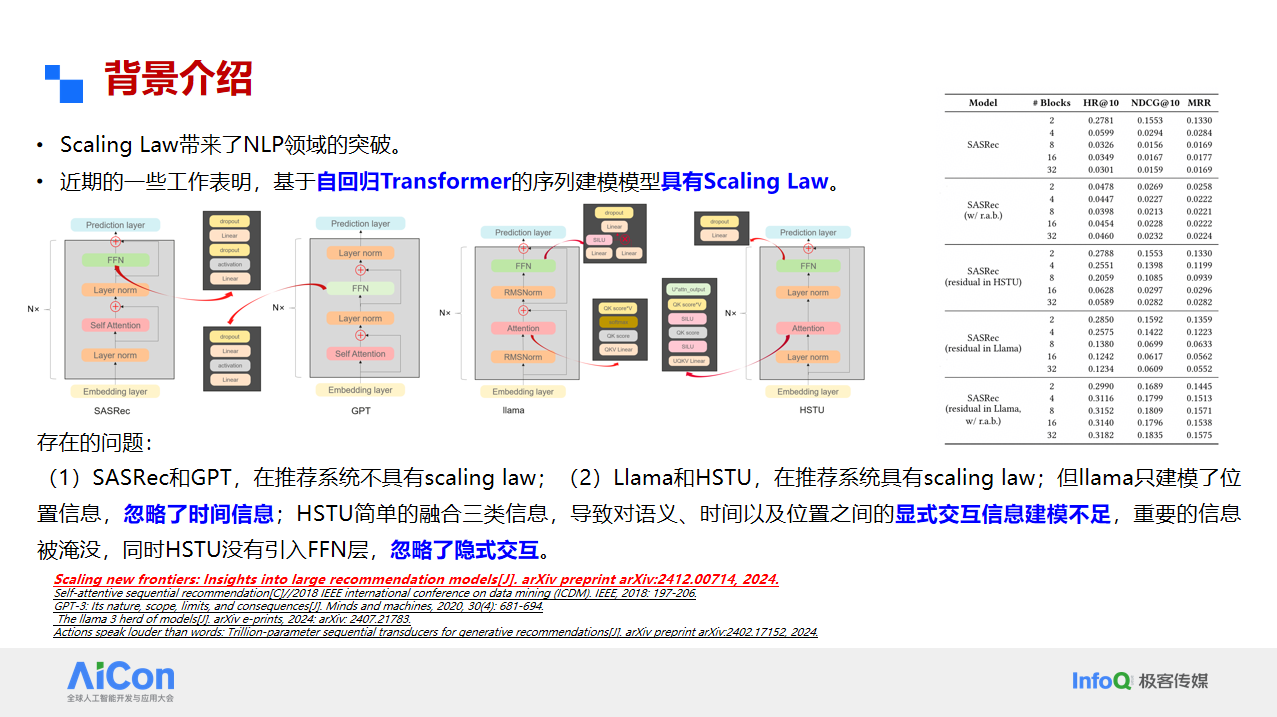
首先从模型结构的探索展开,重点介绍 FuXi- α 、β 模型。自 2024 年 2 月 Meta 发布 HSTU 以来,推荐系统领域迎来了属于自己的 “ChatGPT 时刻”,业界发现推荐系统同样具备 Scaling Law。
受到大语言模型的启发,我们深入开展了基于自回归 Transformer 的序列建模研究。通过对 GPT、Llama、SASRec 以及 HSTU 等典型模型结构,进行复现与对比分析。实验结果表明,传统的 SASRec 和 GPT 在推荐系统场景中不具备规模化效应,而 Llama 和 HSTU 则能够呈现出该效应。
通过分析其核心原因,我们发现模型结构中的残差连接方式与归一化策略起着关键作用。以 Llama 和 HSTU 为代表的结构,将归一化置于注意力机制之前,使特征分布更加稳定与均匀,从而更好支持大规模模型训练。
基于上述分析,我们对经典的 SASRec 模型进行了优化,通过改进其残差结构,并引入时间建模,使其成功展现出规模化效应。这一研究结果表明,规模化效应的核心在于通过合理的结构设计约束表征空间,从而实现模型的更好收敛。
在对现有结构进行充分评估后,我们发现了新的研究挑战:其一,Llama 虽在语言建模任务中表现优异,却缺失了推荐系统中至关重要的时间信息;其二,以 HSTU 为代表的架构虽融合了语义、时间与位置信息,但由于其处理方式较为简单,导致特征交互深度不足,且关键特征的重要性易被掩盖。此外,HSTU 为追求极致的加速效果,舍弃了 FFN 模块,进而忽略了特征之间的隐式交互。
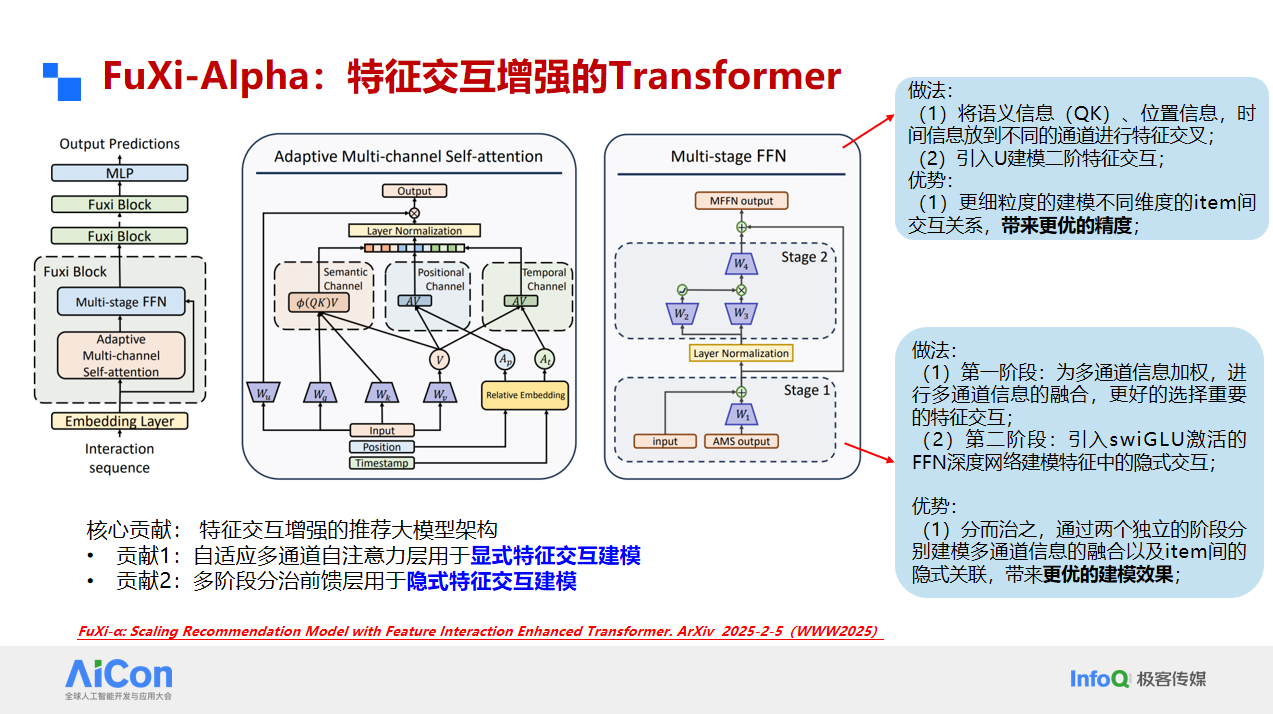
针对上述局限,华为提出 FuXi-Alpha 架构,其核心设计理念为特征交互增强,具体设计方案如下:
其一,引入自适应多通道显式特征交互增强机制。相较于 HSTU 通过简单叠加语义、位置及时间信息所导致的信息丢失问题,FuXi-Alpha 通过构建三个独立通道分别开展特征交叉操作,后续进行拼接处理,可更完整地保留多维特征的表达能力。
其二,设计并引入多阶段前馈网络(FFN),以强化隐式特征交互建模。借鉴 DeepFM 与 DCN 等经典模型的成功实践经验,深度神经网络模块对推荐系统捕获复杂模式具有重要意义,因此 FuXi-Alpha 构建了两阶段 FFN 结构。
该两阶段 FFN 结构的具体功能的为:第一阶段负责多通道信息的深度融合,第二阶段则执行隐式特征的交叉建模。上述设计具备显著优势:一方面能够确保特征交叉建模的充分性;另一方面,由于 FFN 的核心操作主要基于矩阵乘法,具有极高的硬件计算亲和性,可有效提升模型的 MFU。
 (摘要已截断,点击下方"查看原文"获取完整内容)
↗ 查看原文 / 完整内容
https://www.infoq.cn/article/xsPR0sTxb7ItV6J9JHcJ?utm_source=rss&utm_medium=article
 苏公网安备32059002007950号