阿里发布新一代千问旗舰模型Qwen3.7-Max,登顶最佳国产模型
来源:InfoQ AI · 发布于 2026/5/21
撰稿:150 克
大模型进入高速迭代的第三年,行业关注的重点正在发生变化。
过去,外界衡量一家大模型厂商的能力,主要看参数规模、基准测试成绩、盲测榜单排名,以及模型在开放对话中的表现。这些指标仍然重要,但已经不足以回答一个更现实的问题:模型能否真正进入工作流程,稳定调用工具,处理复杂任务,并带来实际效率提升。
5 月 20 日,阿里巴巴发布新一代千问旗舰模型 Qwen3.7-Max。
单看这次发布,它像是千问的一次模型升级。但放在过去几个月的产品演进中看,方向就比较清楚:千问 3.x 系列持续强化编程、长上下文、工具调用、跨框架兼容和长程任务处理能力。这些能力指向同一个变化——模型正在从回答问题,走向执行任务。
这也反映出阿里对大模型竞争的未来判断。下一阶段,模型不应只停留在对话和内容生成上,而需要进入研发、办公、数据分析、客户服务、企业运营等具体场景,理解需求、拆解步骤、调用工具,并完成更复杂的工作。
因此,Qwen3.7-Max 的发布是阿里把模型、云、MaaS、开发者工具和真实业务场景连接起来,参与 Agent 时代竞争的一个重要节点。
一、三个月三次迭代,千问位列国产模型第一
大模型行业的竞争周期正在缩短。
过去,重要模型版本通常半年或一年发布一次。如今,模型更新频率明显提高。厂商需要更快吸收评测反馈、用户调用数据、真实业务需求和工程优化结果,并把这些反馈转化为下一轮训练和产品迭代。
千问正在成为这一趋势中的“领跑者”。
近三个月内,千问旗舰模型连续迭代 Qwen3.5、Qwen3.6、Qwen3.7 三个版本。从 3 月 20 日 Qwen3.5-Max-Preview 亮相,到 4 月 20 日 Qwen3.6-Max-Preview 发布,再到 5 月 20 日 Qwen3.7-Max 发布,千问保持了稳定的月度更新节奏。这样的迭代速度,即便放在全球大模型厂商中,也并不常见。
与此同时,开源模型也在扩大千问的影响力。Qwen3.6-27B、Qwen3.6-35B-A3B 等模型在开源社区获得较多关注,被视为适合本地部署和二次开发的代表。
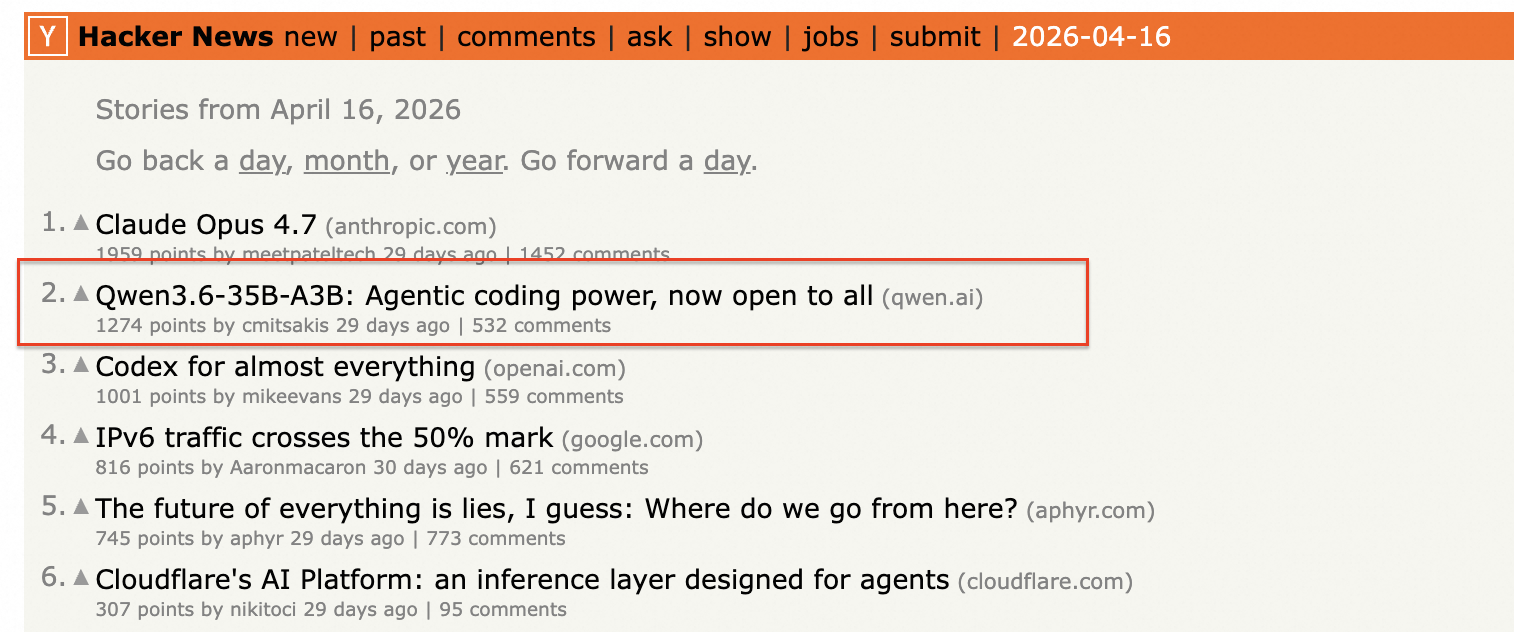
不过,千问近期最重要的变化,并不只是更新更快,而是方向更集中。
过去,大模型发布往往围绕参数规模、综合榜单和推理能力展开。到了千问 3.x 系列,这一重点开始更明确地转向 Agent。Qwen3.5 强调“原生多模态智能体”,Qwen3.6-Plus 强调“面向现实世界智能体”,随后发布的多个版本,也都把 Agentic Coding、工具使用和工程任务作为重点。
Qwen3.7-Max 也延续了这一方向。
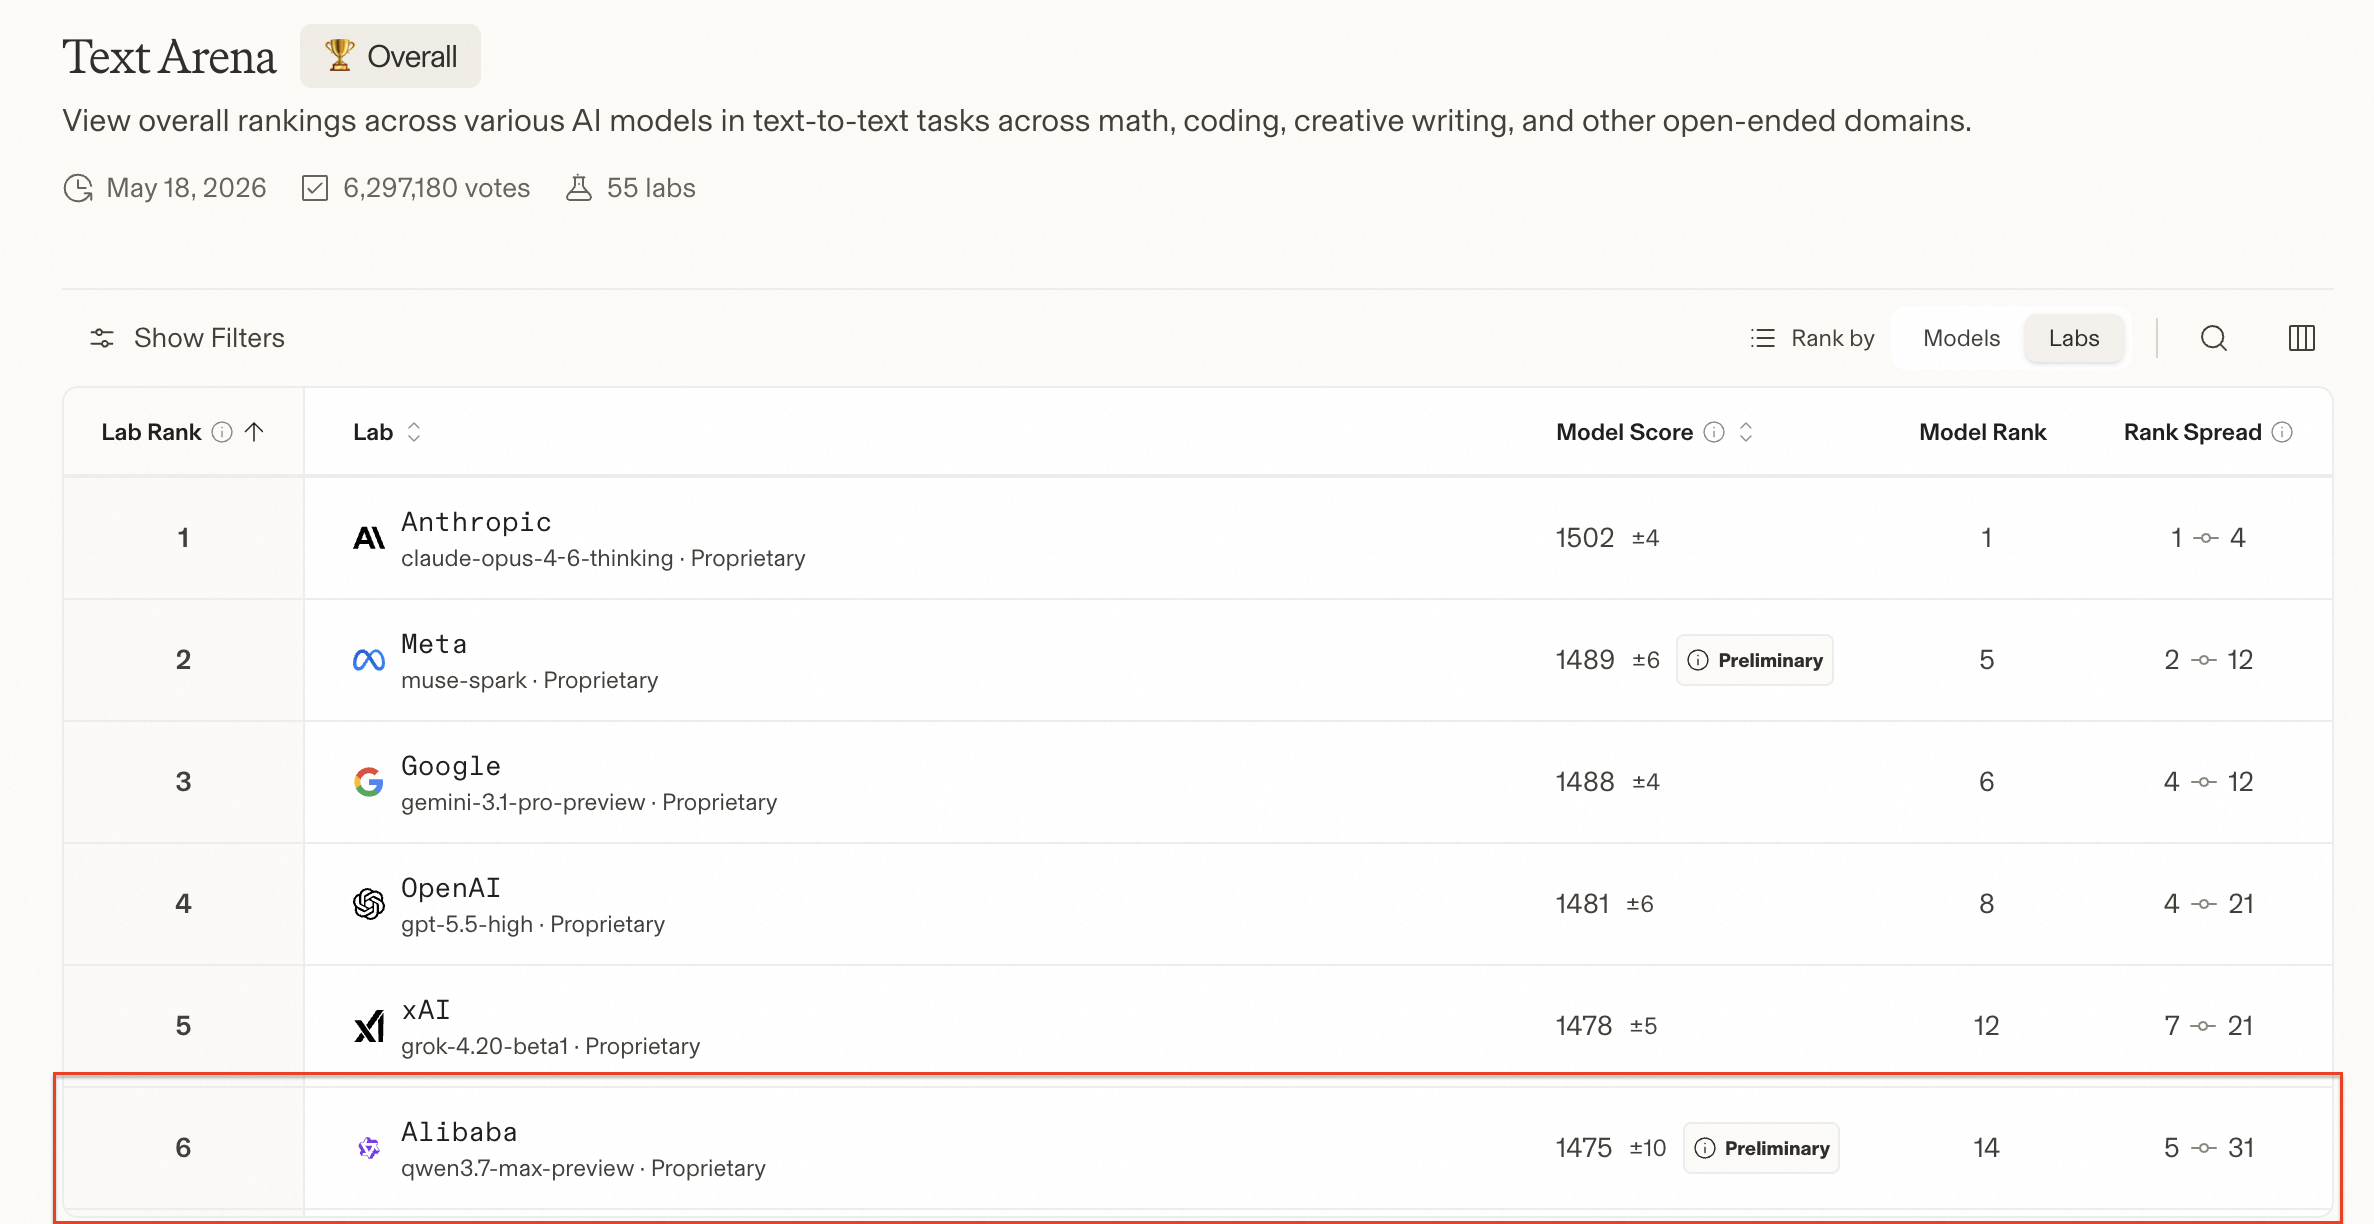
在第三方机构 Arena 全球大模型盲测总榜中,Qwen3.7-Max 超过 Kimi-K2.6、DeepSeek-v4-pro、GLM-5.1,与 GPT、Claude、Gemini 等最强模型接近,位列国产模型第一。
在通用智能体方面,Qwen3.7-Max 也有明显提升。它在 MCP-Atlas、MCP-Mark、SkillBench 等现实能力测试中表现优异,超过 GLM-5.1、Kimi-K2.6 等模型,创下国产模型新高;在 Kernel Bench L3 上,也展示出较强的 GPU 内核优化能力。
推理能力方面,Qwen3.7-Max 在 GPQA Diamond、HLE、HMMT 2026 Feb、IMOAnswerBench 等核心测评中,均超过 Claude-Opus4.6 及所有国产模型。
通用能力与多语言方面,Qwen3.7-Max 在指令遵循 IFBench 评测中取得 79.1 分,刷新新高;在多语言理解和翻译相关的 WMT24++、MAXIFE 评测中也保持领先。
这些结果说明,千问的模型演进正在围绕 Agent 所需能力展开:更长的上下文、更稳定的工具调用、更强的代码理解能力、更好的多轮任务保持能力,以及更适合规模化部署的推理效率。
也就是说,Qwen3.7-Max 不是一次单纯的“冲榜”,而是千问 Agent 路线上的阶段性结果。
二、编程与长程任务突破背后,千问模型的进化暗线
在 Agent 场景中,编程是最早进入高强度竞争的领域。
软件工程天然适合被拆解、执行、验证和迭代。一个 CodingAgent 不只是生成代码,还要理解需求、阅读代码仓库、修改文件、运行命令、查看日志、定位错误,并根据反馈继续修复。
这正好对应 Agent 的核心能力:规划任务、调用工具、执行步骤、检查结果和自我纠错。
因此,千问最近几代模型都在持续强化编程能力。
最新发布的 Qwen3.7-Max 在编程智能体能力上继续突破。在 SWE-Pro、SWE-Multilingual、Terminal Bench 2.0-Terminus、SWE-bench 系列及 SciCode 等测评中,Qwen3.7-Max 表现领先,较 Qwen3.6-Plus 大幅提升,并超过 DeepSeek-v4-pro-Max、Claude-Opus4.6、Kimi-K2.6 等模型。
这代表了编程模型竞争的变化。单纯生成代码的价值正在下降。更重要的是理解复杂代码仓库、自主调用工具、运行测试、修复错误,并在多轮反馈中持续调整。模型正在从“代码助手”向“虚拟工程师”演进。
在我的实际测试中,Qwen3.7-Max 也体现出这种变化。
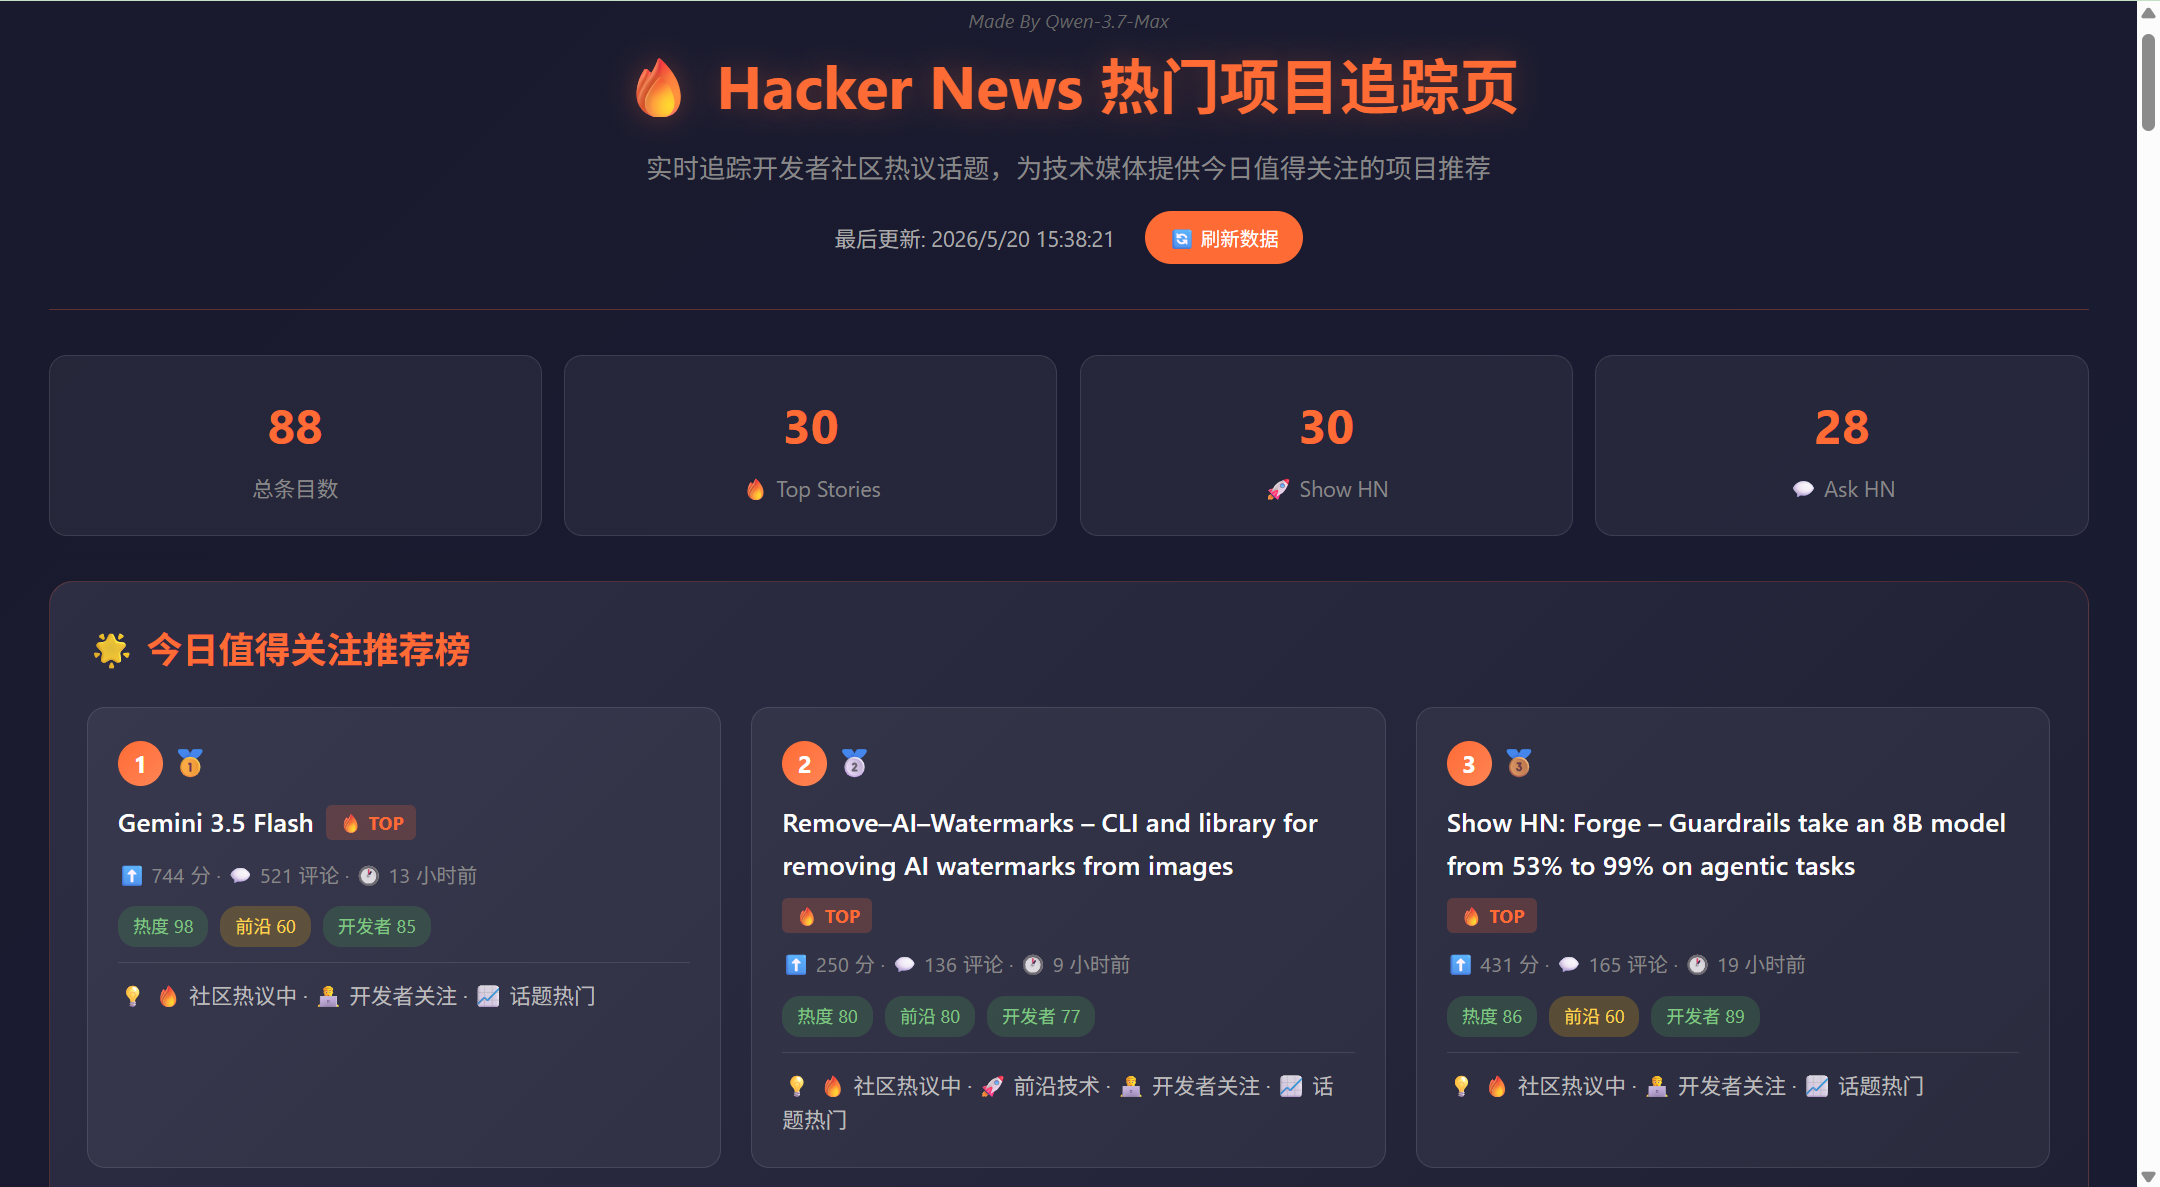
我使用 Cursor、Cline,并通过 OpenAI Compatible 协议接入千问最新模型 API,向模型提出了一个完整网页开发任务:
制作一个名为“Hacker News 热门项目追踪页”的网页,抓取 Hacker News 的 Top、Show、Ask 内容,每日更新,并给出推荐分析,判断技术媒体当天应
(摘要已截断,点击下方"查看原文"获取完整内容)
↗ 查看原文 / 完整内容
https://www.infoq.cn/article/jAICqmzYVqQ8sHdGSzEH?utm_source=rss&utm_medium=article
 苏公网安备32059002007950号