打破向量检索的局限:RAG 混合检索实践
来源:InfoQ AI · 发布于 2026/6/12
你的公司最近上线了一个内部全能搜索系统,这是一个单体系统,采用检索增强生成(RAG)技术构建,可检索公司的待办事项、设计文档、发布文档、运维手册和纠错文档(COE)。工程师、产品经理和经理通过基于大语言模型的聊天界面进行查询,各团队还将其封装为 MCP 工具,让他们的 AI 编程助手可以直接获取上下文。
然后,生产支持组的一名值班人员输入:”在生产环境中启用 payment_v2_enforce 功能标志的运维手册“,聊天助手却提示应禁用该功能。在系统内部,文档根据嵌入相似度进行排名。
对于嵌入模型来说,这两份运维手册看起来几乎完全相同。它们有相同的功能标志名称、相同的服务、相同的词汇和相似的上下文。但值班工程师看不到这个排名,他们看到的是聊天助手根据检索器返回的前 K 条内容生成的回答(有时正确的运维手册甚至不在前 K 个结果里)。这类回答轻则信息失真,重则看似笃定却完全错误。
如果你构建过基于嵌入的搜索系统,对这类情况想必并不陌生。系统能把握整体方向,却忽略了关键的细节信息。
上述查询需要两样东西:对”功能标志运维手册“的语义理解,以及对操作(启用与禁用)的精确匹配。向量搜索只处理了前者。
这并非嵌入模型的缺陷,而是向量相似度的固有特性。嵌入机制会检索出和查询内容相似的结果,而非完全匹配的内容。由于检索将前 K 个结果作为上下文输入大语言模型,排名与召回同样重要。
即便正确答案在前 K 条结果里,若错误答案排序更靠前,依然无法解决问题。修复方案并不是要替换嵌入技术,而是将其与传统文本关键词匹配相结合,让概念相关性和精准术语匹配共同作用于最终的排序。
纯向量检索 RAG 流程的短板
想要理解为什么会出现这个问题,不妨放眼审视一下完整的流程。如图 1 所示,RAG 流程共分为三个阶段。
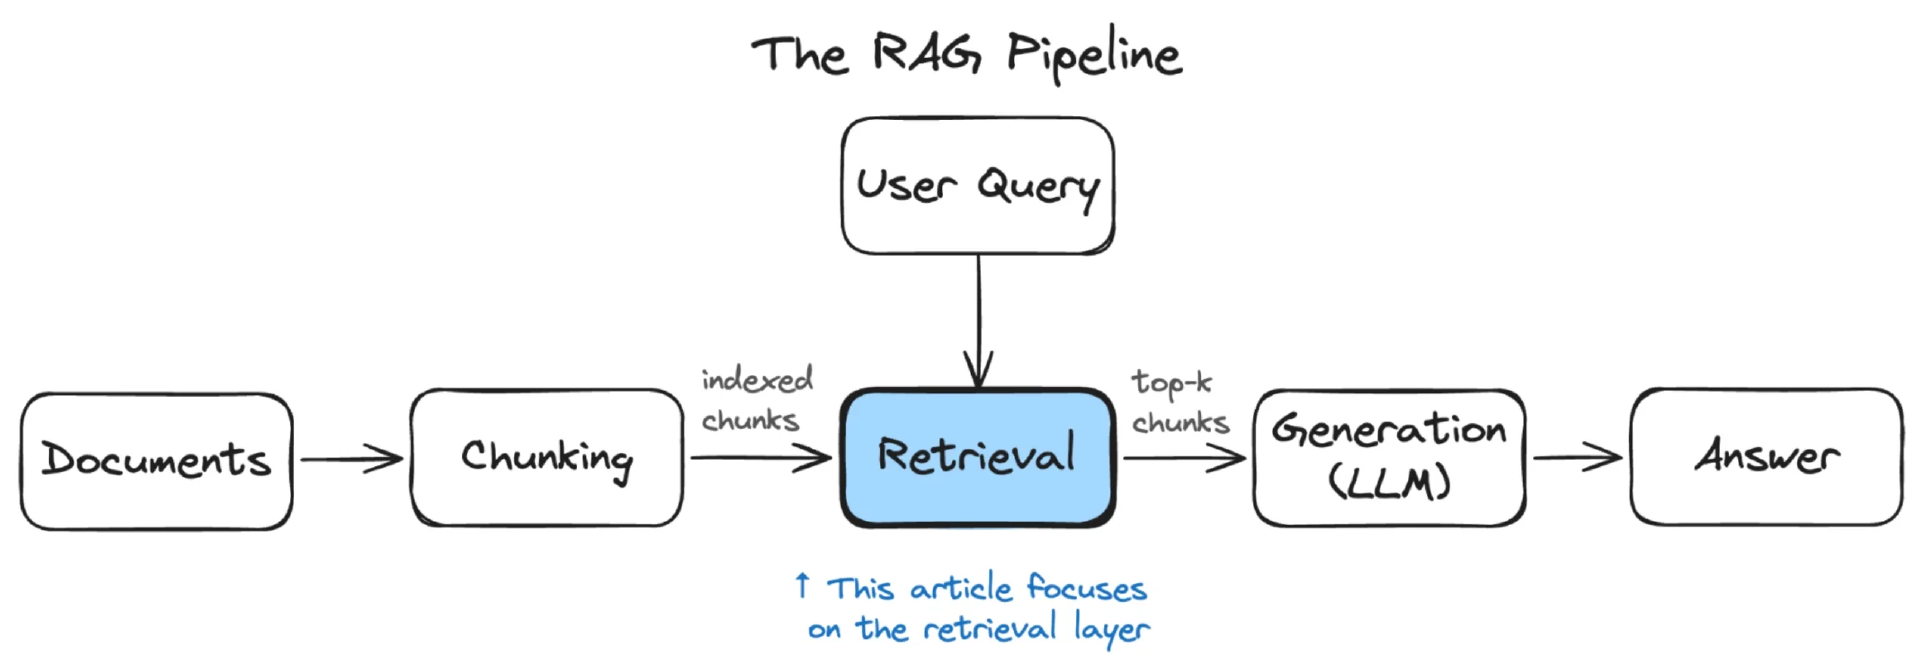
图 1. 典型的 RAG 管道有三个阶段:分块、检索和生成。(来源:作者创建)
图 1 中的元素定义如下:
分块:将原始语料库拆分为可用于索引的单元。
检索:接收用户查询,在分块内容中检索并返回相关性最高的前 K 个块。
生成:将这些分块内容作为上下文输入大语言模型,由模型生成答案。
假设第一、第三阶段均正常运行:文档按合理边界完成拆分,大语言模型根据提供的上下文生成答案,且不会产生幻觉。问题出在前文提及的检索阶段。检索器先对查询做嵌入处理,再将其与已建立索引的文档向量比对,返回嵌入空间距离最近的文档。嵌入空间距离相近,表示语义相似,而非内容完全一致。针对同一功能标志的两份运维手册,一份说明启用操作、一份说明禁用操作,二者在嵌入空间中距离极近。两份文本仅个别词汇存在差异,嵌入模型会为这类高度相似的文本生成近乎一致的向量,导致检索器难以精准区分。因此,当用户查询启用功能标志的运维手册时,禁用相关的手册有时反而距离更近,检索器会以同等置信度推送这份错误文档。这便是问题所在:依靠同一向量空间与评分机制,最终排在前面的却是错误的文档。
问题在于嵌入的本质是近似计算
像 BERT 这样的嵌入模型将文本转换为固定维度的数值向量,并捕捉文本的语义信息。语义相似的文本生成相似的向量。”功能标志“、”终止开关“、”发布门“和”配置切换“在向量空间中紧密聚集。这种聚类在用户检索相关概念时能发挥很大作用,但当用户需要查找精确实体、特定功能标志名称、特定错误代码或特定部署版本时,问题就转到了检索精度层面。
相似的表现同样存在于各类不同失效模式中。当某人搜索 ERR_PAYMENT_GATEWAY_TIMEOUT 时,相关代码如 ERR_PAYMENT_GATEWAY_REJECTED 和 ERR_PAYMENT_GATEWAY_UNAUTHORIZED 等相关代码最终都会与查询向量趋近,因为它们有相同的 ERR_PAYMENT_GATEWAY 前缀并出现在同类故障排查文档中。区分它们尾部词汇的权重占比很低。嵌入模型的行为完全符合设计初衷,它的作用是检索相似内容,而非精准匹配完全一致的内容。当区分特征在文本中占比过低时,嵌入会抹平这种区别。
图 2 展示了嵌入空间的特征:语义相近的内容会聚集在一起。在同一个聚类内部,想要区分不同具体实体(比如介绍功能标志启用、禁用操作的运维手册)就会变得困难。而混合搜索,正是为了解决这类精度不足的问题。
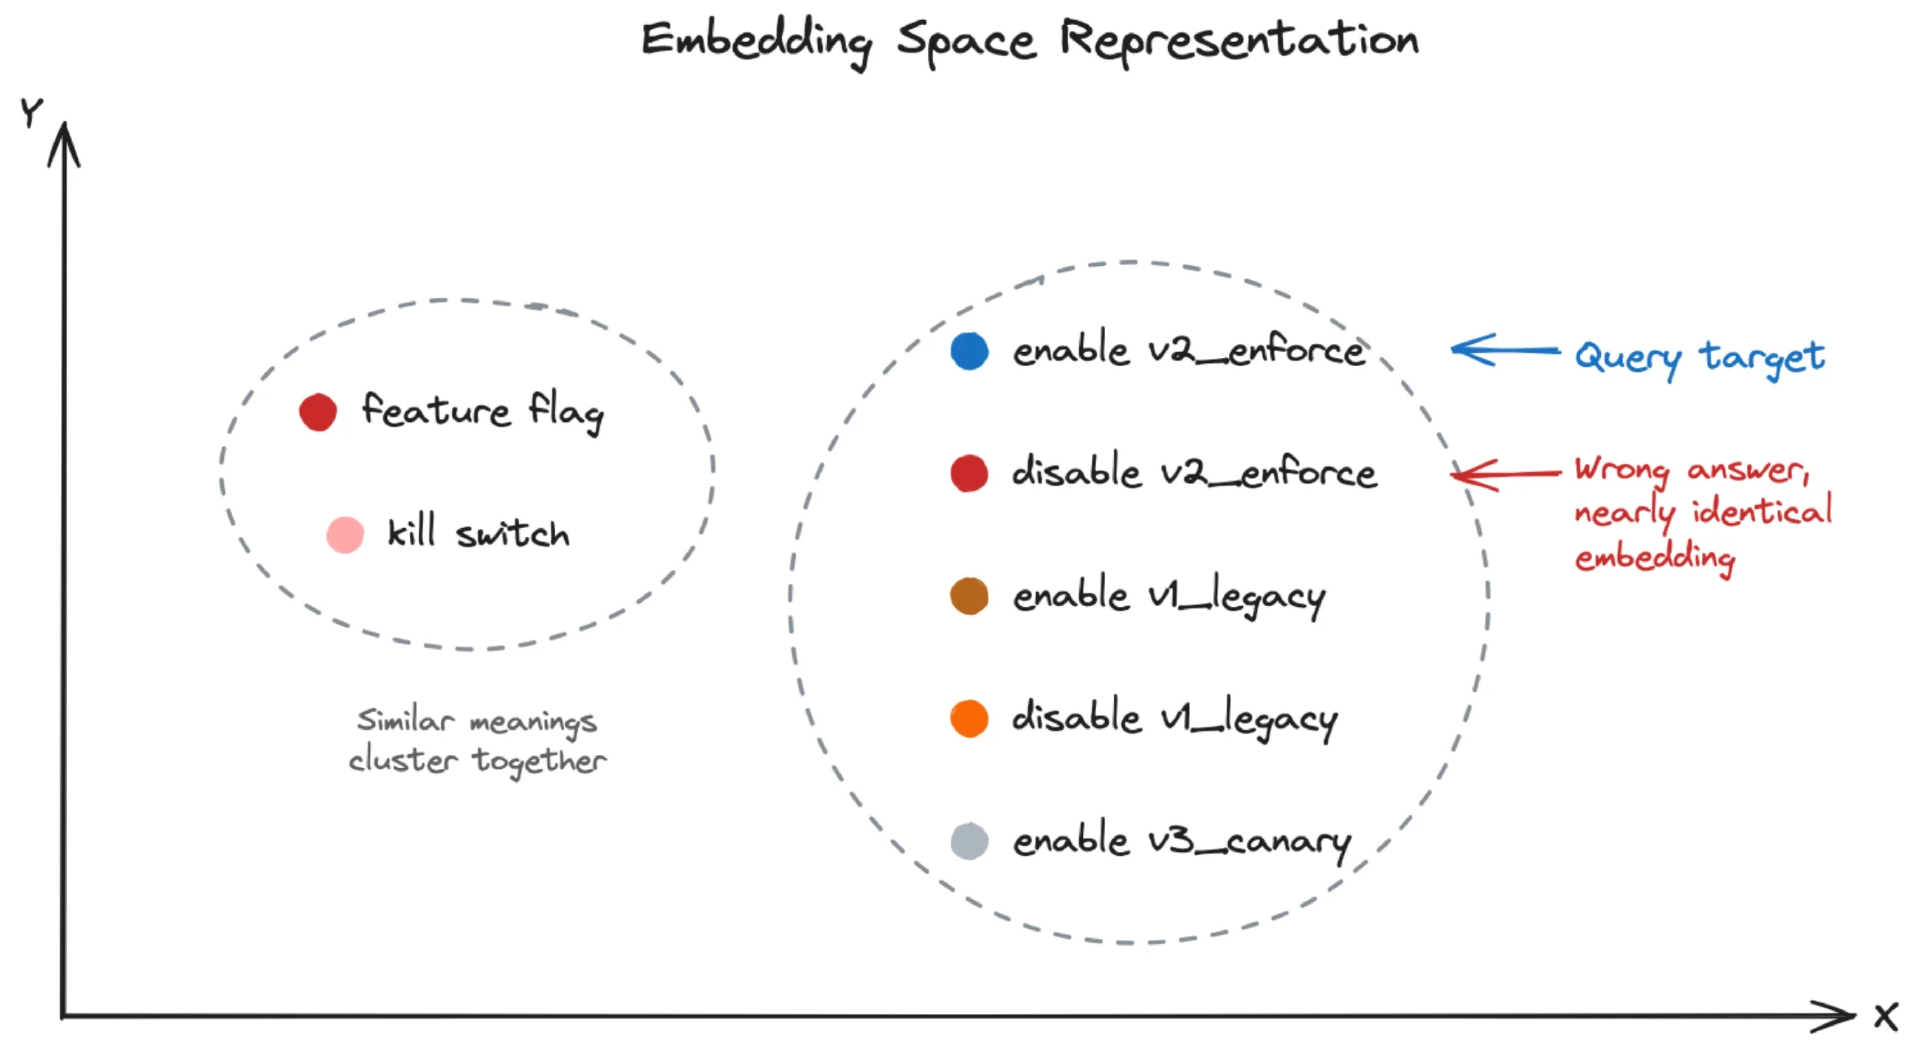
图 2. 语义相似的项目聚集在一起。并非每个查询都有相同的问题。(来源:作者创建)
根据检索方法的适用程度,搜索查询可以被分为三种类型。
语义查询
用户的提问“当一个区域离线时,我们的协议是什么?”是概念类查询。标题为“灾难恢复架构”、“主主复制策略”、“故障转移运维手册”的文档,即便和查询没有共用词汇,也理应获得较高排名。嵌入模型能很好地应对这类场景,因为它捕捉的是语义,而非单纯匹配字面词汇。
精确匹配查询
这类查询在信息检索文献中也称为词汇查询。用户将堆栈跟踪或日志中的错误代码粘贴到搜索栏中,如 (摘要已截断,点击下方"查看原文"获取完整内容)ERR_PAYMENT_GATEWAY_TIMEOUT,此时他们明确知晓自己要查找的标识。对于这些查询,语义相似性反而不是用户想要的。向量嵌入可能会推送语义相近但标识不同的文档(如包含 ER
↗ 查看原文 / 完整内容
https://www.infoq.cn/article/QC1mkdEzZRL1FFpvfukC?utm_source=rss&utm_medium=article
 苏公网安备32059002007950号