对话灵感实验室:全帧率 VLM、低成本与分层部署,业务现场不止需要炫技模型
来源:InfoQ AI · 发布于 2026/5/21
作者|陈姚戈
编辑|王一鹏
当多模态大模型成为显学,许多本属于 CV 领域的问题,又被重新摆到了台前。
“大部分现有模型,不管是视频生成模型,还是 VLM,都是先把视频拆成一帧一帧的图片,再用图像编码器编码,最后送进模型。”格灵深瞳旗下灵感实验室 Glint Lab 负责人冯子勇对 InfoQ 表示,“而且这些视频输入都经过抽帧。”
冯子勇所说的“抽帧”,是今天许多视频理解模型默认接受的工程选择。不管是 GPT-4o、Gemini 1.5 Pro 这样的闭源模型,还是 Video-LLaVA、InternVL2、Video-LLaMA 这样的开源模型,很多做法都是按固定间隔抽取帧,或者将长视频切分成数秒级短片段,再送入模型处理。
这么做并不难理解。
一小时视频如果按 24 FPS 计算,就包含近 9 万帧。即使每一帧只产生很少的视觉 token,全帧率输入也会迅速把上下文窗口、显存和推理成本推到难以承受的水平。更何况,视频天然存在大量冗余:相邻帧之间大部分背景、物体和场景并没有变化。把每一帧都完整编码一遍,直觉上就不经济。
因此,过去两年,不少视频编码的研究都在改进抽帧策略。例如从固定间隔采样,走向更智能的关键帧选择。
但在冯子勇看来,只要模型仍然把视频拆成一张张图片来处理,无论抽帧策略如何优化,本质上都没有真正利用视频本身的连续结构。
这条路线可行,但存在巨大浪费。
“图像只是一个瞬间,它前后的连续关系没有在前端建模起来,而是都丢给后端模型去理解。”冯子勇说,“这相当于迫使 LLM,或者中间的模型,去重新理解图和图之间的关系。这不是说不能做,但是很浪费。”
浪费来自两个层面。
第一,算力被浪费了。视频原本就是连续的,相邻帧之间天然存在关系。但在传统流程里,视频先被解码成一张张静态图片,原有的连续结构被打散,模型再用昂贵的计算把这种关系重新学回来。
第二,信息结构被浪费了。视频编码器本身早已在工程世界里存在多年。I 帧、P 帧、运动向量、残差,这些机制原本就是为了描述哪些内容稳定不变,哪些内容发生了变化。视频在被压缩和传输时,已经把很多时空关系显式编码出来了。但今天许多多模态模型的做法,是先把这些结构解开,再让模型重新发现一遍。
面对这些问题,冯子勇认为,可以换一种方式理解视频输入。
“既然视频原来已经有建模好的东西,为什么不直接用这些东西,在上面构建更 compact 的 token,或者更 compact 的表示?让这些本来就存在的信息,直接传给模型。 ”
这种思考萌发于灵感实验室成立之前,并在实验室成立后得以实现。
格灵深瞳一直关注视觉基座和视觉表征能力。出于对模型应用落地的考量,格灵深瞳认为“在后端大模型上堆计算”这件事有持续优化的空间,并且更关心前端视觉编码能否把有效信息提取出来,能否用更少 token 表达更完整的视频内容,能否在效果、成本和部署复杂度之间取得平衡。
2023 年底,随着大模型能力提升、工具链变化,以及客户对多模态能力需求的增加, 格灵深瞳成立灵感实验室 Glint Lab,给予团队更大的研究自主性。 此后,灵感实验室围绕视觉基座和视觉解码框架,先后开源了 RICE-ViT、LLaVA-OneVision-1.5、OneVision-Encoder 等模型。
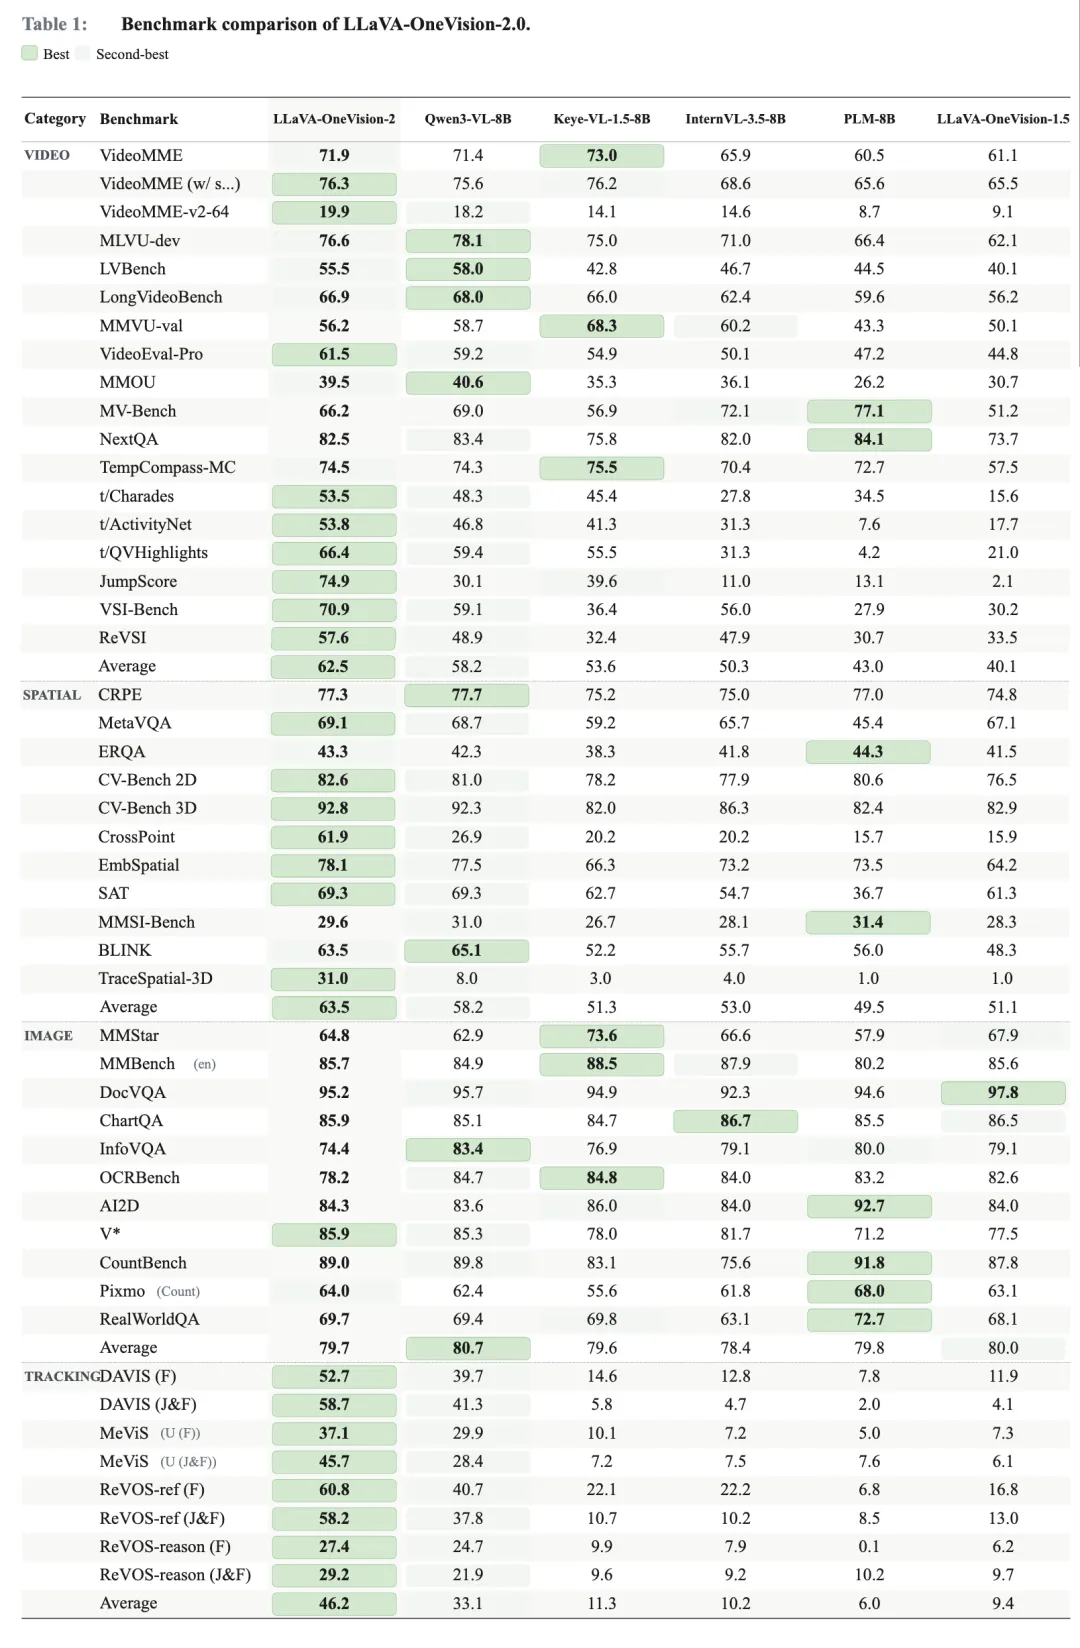
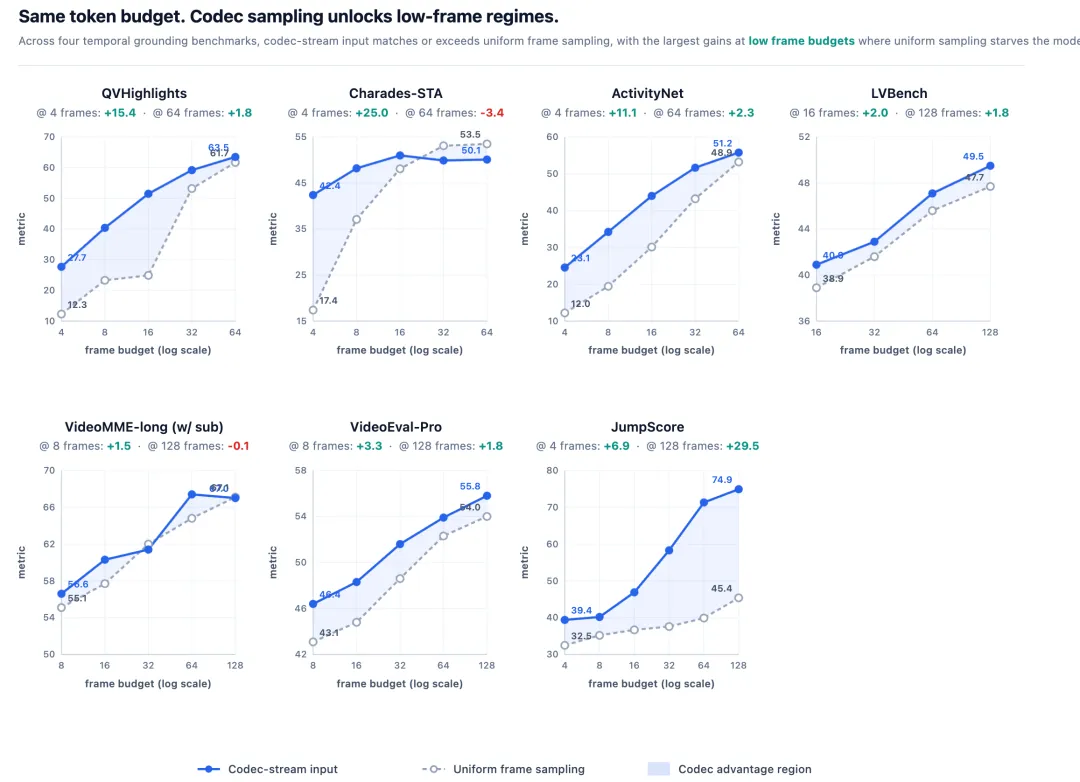
LLaVA-OneVision-2.0 是最新成果。它延续了 LLaVA 系列“视觉基座—projector—LLM”的基本架构,并引入基于 codec 的密集视频输入策略,在保留全帧率感知的同时,降低视频 token 消耗。
LLaVA-OneVision-2.0 的目标,是突破长视频理解中时长、成本和细节的瓶颈。
它通过四阶段渐进式训练,把模型的视频理解能力从 30 秒短片逐步扩展到 10 到 15 分钟长视频,并进化到具备 2D/3D 空间定位和物体追踪的能力。在训练过程中,团队也借助了百度百舸开源的全模态训练框架 LoongForge,为相关训练与迭代提供支撑。
在编码方式上,它采用了 OneVision-Encoder 作为视觉底座。这是一个专门研发的、拥有 24 层结构的 ViT 模型,它负责接收图像或视频输入,通过共享时间、高度和宽度三个维度的位置编码,将其转化为带有语义和时序信息的视觉 token。
OneVision-Encoder 能利用视频 codec 中已经存在的信息结构,保留 I 帧提供的完整空间上下文,P 帧则记录相邻帧之间的运动和残差变化。模型因此可以从 P 帧中提取运动和变化更明显的 patch,不必把每一帧都当成完整图片重新编码。
左图是均匀帧采样(Uniform 128 Frames)
右图是 OneVision-Encoder 基于编解码器选择的图块采样(Codec-Selected Patches)
根据灵感实验室提供的测试结果,LLaVA-OneVision-2.0 在部分视频理解任务上接近 Qwen3-VL 的效果,同时显著降低了 token 成本。
相关链接:
GitHub:https://github.com/EvolvingLMMs-L
(摘要已截断,点击下方"查看原文"获取完整内容)
↗ 查看原文 / 完整内容
https://www.infoq.cn/article/7J14Dd3UkwkYoHVjkM9P?utm_source=rss&utm_medium=article
 苏公网安备32059002007950号