基于国产 GPU 全栈训练,摩尔线程 MusaCoder 正式开源:KernelBench 得分超越 Opus 4.7
来源:InfoQ AI · 发布于 2026/6/11
近日,摩尔线程正式发布并开源面向 GPU 底层算子生成的专用代码大模型 MusaCoder。这是业内首个基于国产 GPU 算力底座完成全链路训练与验证的开源代码大模型,其完整后训练流程均在基于 MTT S5000 构建的夸娥智算集群上完成。在 KernelBench 严格评测中,MusaCoder-27B-RL 以 Overall Pass@8 93.2%、Avg.@8 88.60%的成绩,超越 Claude Opus 4.7、GLM-5.1、DeepSeek-V4 Pro、Kimi K2.6 等主流 SOTA 代码模型。
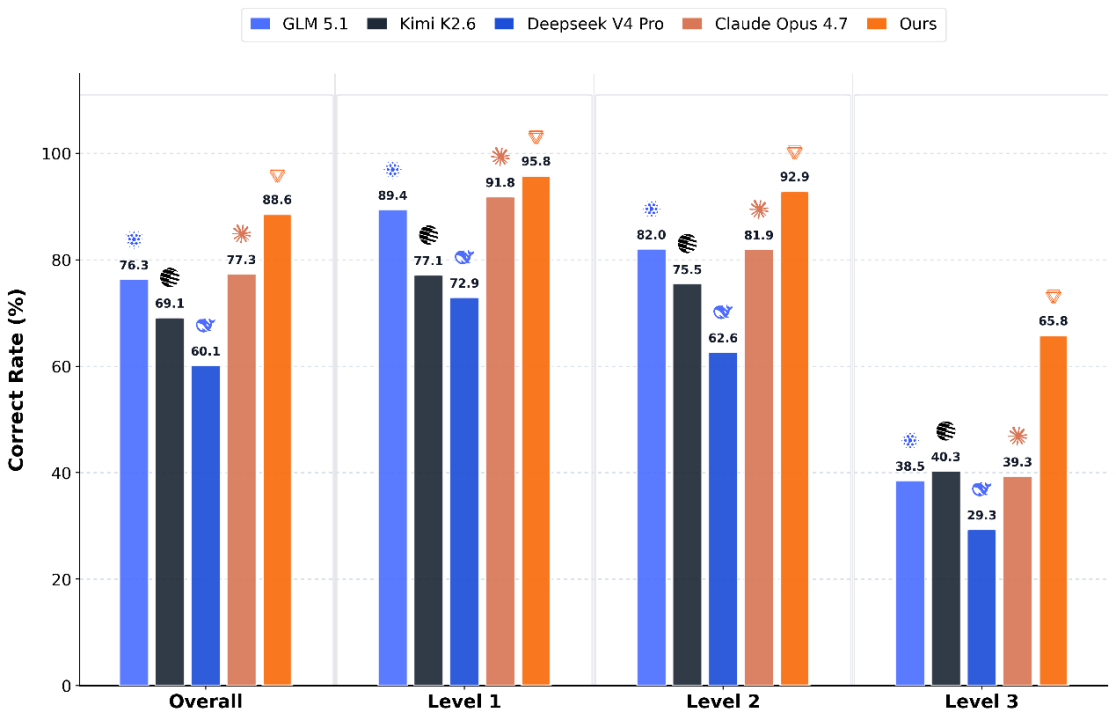
KernelBench 准确率(Avg.@8)对比
MusaCoder 模型权重已开源:https://huggingface.co/MooreThreads/MusaCoder-27B
MusaCoder 论文地址:http://arxiv.org/abs/2606.04847
MusaCoder:专为 GPU 设计的高性能算子生成模型
MusaCoder 是摩尔线程面向 GPU 底层算子生成任务设计的专用代码大模型,包含 9B 和 27B 两个参数规模。该模型重点支持从 PyTorch 标准算子自动生成高性能 CUDA/MUSA 原生 Kernel 代码,旨在降低开发者手写底层 GPU 算子的门槛,提升 GPU 高性能计算场景下的代码生成、验证和优化效率。
传统代码大模型虽然具备较强的通用编程能力,但在 GPU Kernel 生成任务中仍面临显著挑战:一方面,GPU Kernel 对并行计算、线程组织、内存访问、索引映射和硬件执行特性要求极高;另一方面,生成代码不仅要语法正确,还必须能够通过编译、数值正确性验证、反作弊检测,并在真实执行中获得性能收益。
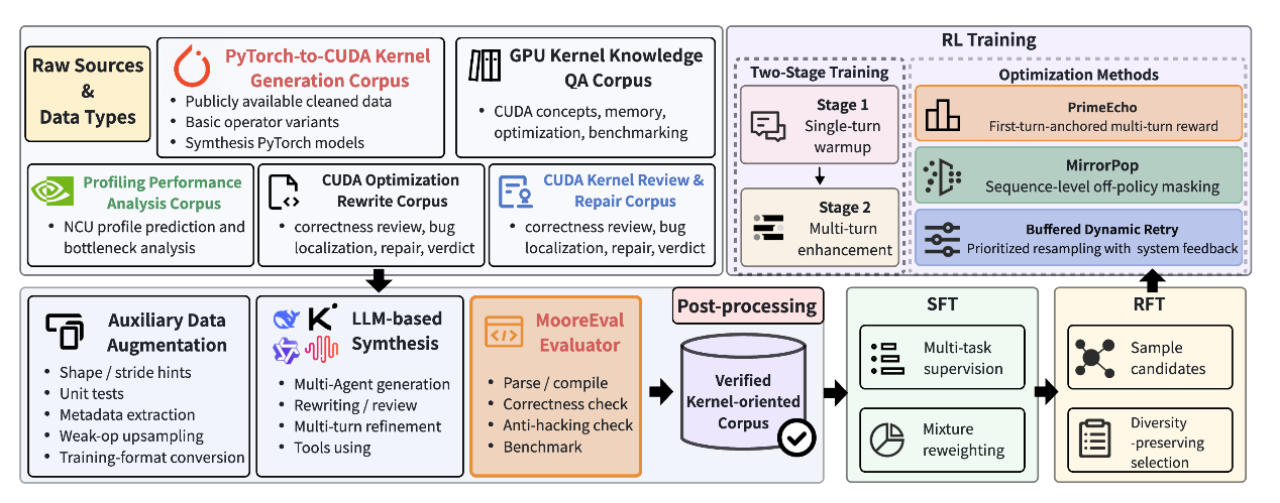
MusaCoder 训练总流程
针对上述难点,MusaCoder 构建了一套面向 GPU 原生算子(CUDA/MUSA)生成的大模型全栈后训练方法论。该流程覆盖数据构建、执行验证、强化学习优化等关键环节,使模型能够从基础代码能力逐步进化为具备底层算子生成与修复能力的专用模型。
在数据构建阶段,MusaCoder 通过结构化推理过程和显式 Shape 信息注入,增强模型对张量形状、内存布局和索引关系的理解,解决从通用代码能力迁移到 GPU Kernel 生成任务时的冷启动问题。
在评测与训练环境方面,摩尔线程构建了 MooreEval 分布式执行验证系统。MooreEval 能够对模型生成的代码进行自动编译、执行、正确性验证、性能测试和反作弊检测,并将结果转化为稳定的训练反馈信号。这使得模型不仅能学习“写出能运行的代码”,还能够进一步学习“写出正确、合法且更高效的原生 GPU Kernel”。
在强化学习阶段,MusaCoder 针对 GPU Kernel 生成任务中的多轮修复、训练稳定性和长尾困难样本等问题,引入了 PrimeEcho、MirrorPop 和 BDR 等机制,用于提升模型在多轮调试场景下的修复能力和训练稳定性。通过这些方法,MusaCoder 打通了从基础代码微调到执行反馈强化学习的完整优化闭环。核心成果:正确率与真实加速能力双提升。
在 MooreEval 执行式验证协议下,MusaCoder-27B-RL 在 KernelBench 评测中表现的性能优于其他国际顶尖模型。
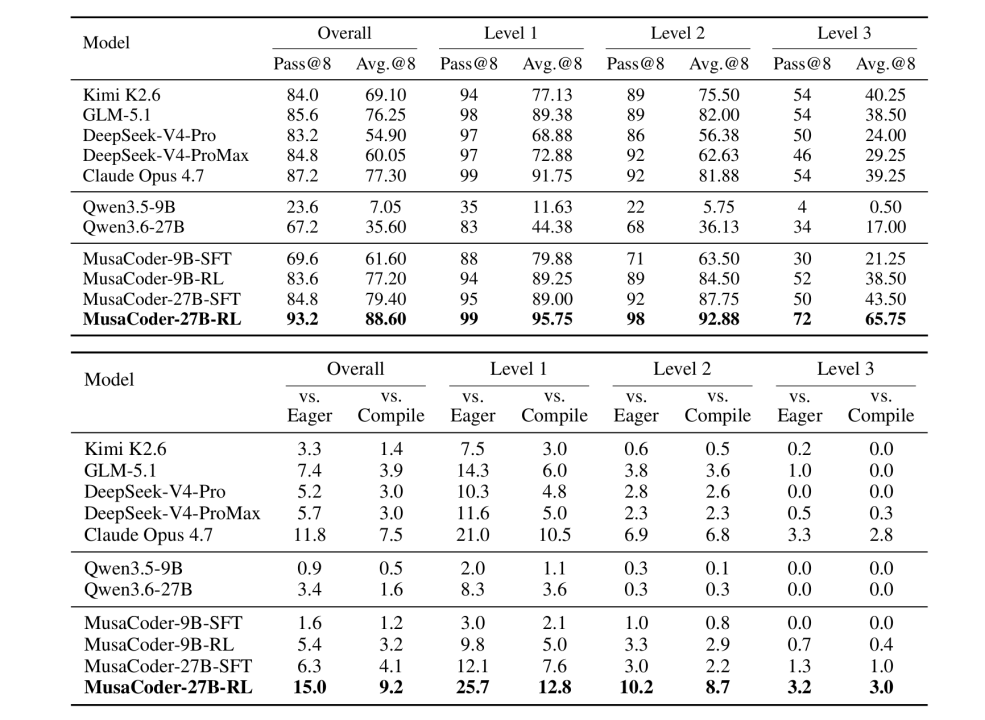
表 1:KernelBench 评估结果对比。Pass@8 表示 8 个采样代码中至少有一个通过验证,而 Avg.@8 则衡量 8 个样本的平均正确率。
高准确率超越 SOTA:从正确率来看,MusaCoder-27B-RL 的 Overall Pass@8 达到 93.2%,Avg.@8 达到 88.60%,均超过 Claude Opus 4.7 的 87.2%和 77.30%。在更具挑战性的 Level 3 任务上,MusaCoder-27B-RL 的优势更加明显。
Level 3 任务通常涉及复杂 shape 推导、索引映射和多算子组合,对模型的底层代码理解能力和调试能力提出了更高要求。在该难度级别上,MusaCoder-27B-RL 的 Pass@8 和 Avg.@8 分别领先 Claude Opus 4.7 的 18 个百分点和 26.5 个百分点。
真实加速能力突出:在 MooreEval 标准下,只有同时通过正确性验证、合法性检查,并且相比 PyTorch baseline 获得有效加速的候选实现,才会被计入 Faster Rate。MusaCoder-27B-RL 的 Overall Faster Rate 达到 15.0%(vs. PyTorch Eager)和 9.2%(vs. torch.compile),分别高于 Claude Opus 4.7 的 11.8%和 7.5%。
这表明 MusaCoder 不仅能够更稳定地生成正确的 GPU Kernel,也更有能力生成具备实际性能收益的原生算子代码。
国产 GPU 完成全流程后训练,验证夸娥智算集群能力
MusaCoder 模型的 SFT(监督微调)、RFT(拒绝采样微调)、RL(强化学习)、异步 rollout、在线编译执行验证及 reward 计算等全栈训练与验证流程,均依托摩尔线程旗舰级 AI 训推一体智算卡 MTT S5000 所构建的夸娥智算集群完成。
(摘要已截断,点击下方"查看原文"获取完整内容)
↗ 查看原文 / 完整内容
https://www.infoq.cn/article/zrRC0hYrZ2K49JVWt49E?utm_source=rss&utm_medium=article
 苏公网安备32059002007950号